从零开始学习大模型(十七):一张图理解 Transformer 的整体结构
Transformer 不是单个注意力公式,而是一套组织序列表示与计算的架构。原始设计包含编码器和解码器;后续模型也可以只使用其中一种结构并调整具体模块。
本篇先建立整体数据流,下一篇再展开注意力内部的矩阵计算。
1. 输入如何进入网络
文本先转换为 Token 编号,再通过 Embedding 得到向量表示。若批次大小 B、序列长度 T、隐藏宽度 D,则常见输入形状为 (B, T, D)。
位置机制用于让模型利用顺序信息。它可以是加入输入的向量,也可以改变注意力中的计算,不能把所有实现都理解成在 Embedding 上加同一类位置向量。
| 模块 | 主要作用 | 典型形状变化 |
|---|---|---|
| Embedding | 编号映射为表示 | (B,T) → (B,T,D) |
| 自注意力 | 按访问规则聚合不同位置 | 通常保留 (B,T,D) |
| 前馈网络 FFN | 对各位置执行特征变换 | D → 中间宽度 → D |
| 输出头 | 映射到任务空间 | 如 D → 词表大小 V |
FFN 通常在每个位置使用同一组参数,位置之间的信息交换主要由注意力等模块完成。现代模型可能使用门控前馈层,而不完全照搬原始两层 ReLU 设计。
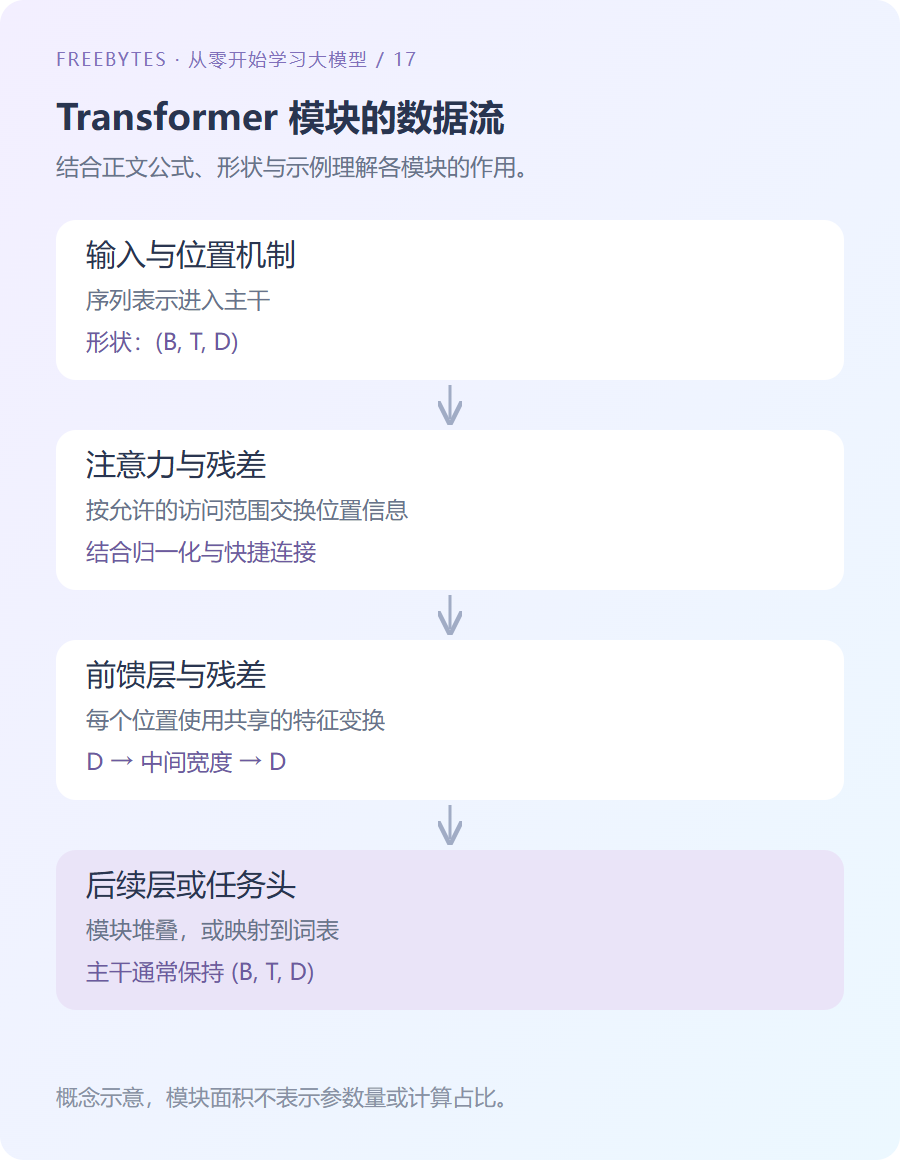
图 1:模块级概念结构。不同实现的归一化位置与前馈函数可能不同。
2. 残差连接与归一化
注意力与 FFN 通常各配有残差路径,使主干宽度保持一致。LayerNorm 在指定的特征维度上归一化,不是对整个批次混合计算均值。
原始常见 Post-Norm 写法可表示为 x ← LayerNorm(x + Sublayer(x))。Pre-Norm 则类似 x ← x + Sublayer(LayerNorm(x))。两者优化特性不同,不能只因模块名称相同就认定实现一致。
归一化可带有可训练缩放与偏移,计算也包含防止除零的小常数。它与数据集层面的标准化、以及将向量长度归一化为 1,都不是同一操作。
3. 编码器与解码器如何协作
| 子结构 | 访问范围 | 典型用途 |
|---|---|---|
| 编码器自注意力 | 可访问允许的全部输入位置 | 产生输入表示 |
| 解码器因果自注意力 | 不访问未来目标位置 | 按前缀生成 |
| 解码器交叉注意力 | 查询来自解码器,键值来自编码器 | 条件生成 |
| Decoder-only 主干 | 常用因果自注意力,无独立编码器 | 自回归语言建模 |
这里的“全部”仍要排除填充或其他受限位置。架构类型和具体任务掩码需要同时检查,不能仅凭 Encoder 或 Decoder 名称推断所有访问规则。
4. 用 PyTorch 检查形状与因果性
下面使用与第十一篇相同的 PyTorch 2.6.0 CPU 环境。编码器形态模块被显式传入因果掩码,仅用于验证模块行为,并不是完整 GPT。
import torch
from torch import nn

torch.manual_seed(4)
layer = nn.TransformerEncoderLayer(
    d_model=8, nhead=2, dim_feedforward=16,
    dropout=0.0, batch_first=True, norm_first=True)
layer.eval()
x = torch.randn(2, 3, 8)
mask = torch.triu(torch.full((3, 3), float('-inf')), diagonal=1)
changed = x.clone()
changed[:, 2, 0] += 100.0
with torch.no_grad():
    output = layer(x, src_mask=mask)
    altered = layer(changed, src_mask=mask)
assert output.shape == (2, 3, 8)
assert torch.allclose(output[:, :2], altered[:, :2], atol=1e-5)
print(tuple(output.shape))
未来位置改变后,前两个位置的输出保持一致,符合本例访问约束。该检查不替代完整语言模型中标签偏移、位置编码和缓存路径的验证。
5. 并行训练与逐步生成
训练时,已知目标序列可通过因果掩码同时计算多个位置的预测,避免让某位置访问未来答案;生成时,后一个 Token 依赖新产生的前缀,通常仍逐步执行。
标准稠密注意力的分数矩阵随长度平方增长,FFN 还会带来较大的特征变换开销。不能将 Transformer 的并行性理解为长文本几乎没有额外成本,也不能认为注意力必然是所有设置中的唯一瓶颈。
下一篇使用两个 Token 手算完整的单头自注意力。原始架构可参考 Attention Is All You Need。