从零开始学习大模型(二十):BERT、GPT 与 T5 有什么区别?
BERT、GPT 与 T5 都与 Transformer 有关,但它们的结构、可访问上下文和预训练任务不同。比较时应同时观察这些条件,而不是简单归纳成某种架构“只能理解”或“只能生成”。
1. 三类结构的典型区别
| 类型 | 常见代表 | 典型上下文方式 |
|---|---|---|
| Encoder-only | BERT | 输入侧可使用双向上下文 |
| Decoder-only | GPT 类模型 | 按因果前缀自回归 |
| Encoder-Decoder | T5 | 编码完整输入,再条件生成输出 |
原始完整 Transformer 解码器包含交叉注意力;常见 Decoder-only 主干不包含一个独立编码器。不同模型变体仍需具体检查。
2. BERT 的掩码语言建模
BERT 预训练的重要任务是预测被选中并按规则处理的输入位置。编码器能够利用左右上下文构建表示,这与只允许访问前缀的语言模型不同。
这类表示可以通过任务头用于分类、序列标注或抽取式问答。具体预训练还包含相应设计,例如原始 BERT 的句间任务;不能把所有后续双向编码器都视为完全采用原始配置。
掩码位置的预测,不等于默认已经具备高效的从左到右对话生成过程。若改变任务与结构,可以开发其他生成方案,但需要单独分析。
3. GPT 类模型如何预测后续 Token
自回归目标最大化各位置真实 Token 在此前上下文条件下的概率。训练输入与目标通常错开一个位置:输入 [BOS,A,B],目标 [A,B,EOS]。
训练时使用真实前缀计算后续预测,常称教师强制。生成时则使用已经生成的前缀。二者的上下文来源不同,模型在生成中出现错误后也可能继续传播其影响。
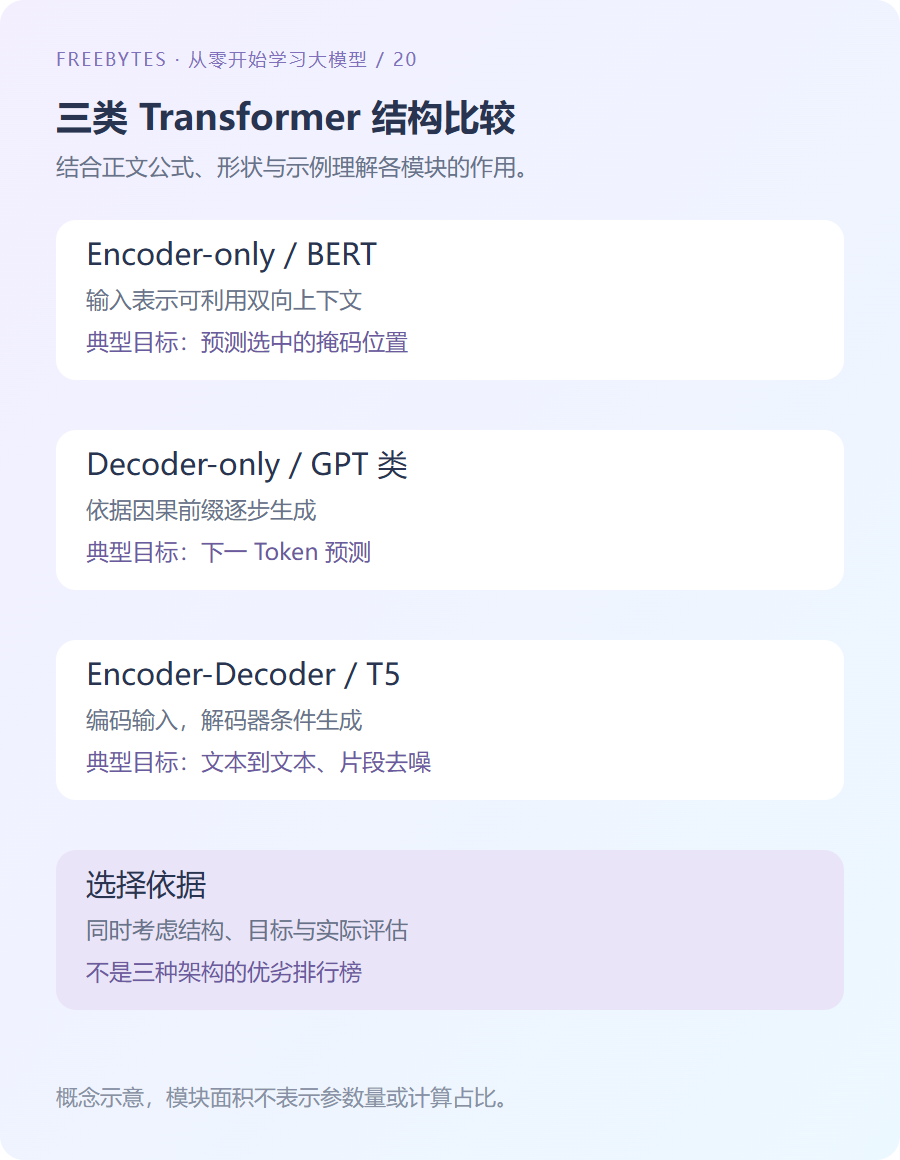
图 1:结构与训练任务的概念比较,并非对所有模型变体的完整分类。
4. T5 如何统一为文本到文本
T5 使用编码器—解码器,把多种任务组织成文本输入与文本输出。预训练可采用片段破坏与恢复等去噪方式,而不是把每个位置都按普通 GPT 目标处理。
| 训练目标 | 输入与目标关系 | 常见检查 |
|---|---|---|
| 掩码预测 | 从可用上下文恢复选中位置 | 哪些位置计入损失 |
| 自回归预测 | 前缀预测下一 Token | 因果掩码与标签偏移 |
| 片段去噪 | 受损输入恢复指定内容 | 哨兵符与输出格式 |
| 任务微调 | 根据任务输入产生目标 | 标签设计与评估方式 |
预训练目标并不单独决定产品能力,后训练、数据、规模和工具也会影响结果。分类、检索与生成的模型选择应由任务条件和实际评估支持。
5. 用最小数据检查标签偏移
下面用手工 Token 编号验证一条自回归训练样本的对齐关系,不运行语言模型,也不声称这些编号来自实际分词器。
tokens = [10, 21, 22, 11]  # 起始符、A、B、终止符
inputs, labels = tokens[:-1], tokens[1:]
pairs = list(zip(inputs, labels))
assert pairs == [(10, 21), (21, 22), (22, 11)]
assert len(inputs) == len(labels)
allowed = [[j <= i for j in range(3)] for i in range(3)]
assert allowed[0] == [True, False, False]
assert allowed[2] == [True, True, True]
print(pairs)
许多训练库在模型内部自动处理偏移,外部再偏移一次会错位;另一些接口则需要显式准备。应查看所用模型的损失接口,而不是仅依据示例猜测。
6. 第五阶段小结
Transformer 的核心可从信息流、矩阵形状、访问掩码与训练目标四个方面理解。下一阶段将把这些结构放进大规模训练与应用流程,讨论 Token、预训练、后训练、显存和知识库问答。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
上一篇:多头注意力、位置编码与因果掩码