从零开始学习大模型(十四):RNN 如何处理顺序与历史状态?
文本、语音与时间序列都有顺序。同一组元素调整排列后,含义或预测目标可能改变。循环神经网络(RNN)通过反复更新隐藏状态,把当前输入与此前计算联系起来。
隐藏状态是一种数值表示,不是完整历史的无损存储,也不能直接等同于应用中的聊天记录。
1. 一次状态更新
单层普通 RNN 可写为 h_t = tanh(x_tW_x + h_(t−1)W_h + b)。当前状态依赖本步输入和上一步状态,输出层可再将 h 映射成类别分数或其他目标。
| 量 | 行向量约定下的形状 | 作用 |
|---|---|---|
| 当前输入 x_t | (B, d) |
本时刻的输入特征 |
| 隐藏状态 h_t | (B, H) |
递推得到的表示 |
| 输入权重 W_x | (d, H) |
将输入映射到状态空间 |
| 循环权重 W_h | (H, H) |
将历史状态纳入计算 |
初始状态可以设为零,也可以根据任务采用其他设置。不同独立序列通常应重置状态,不能无意中把一个用户或样本的状态传给另一个。
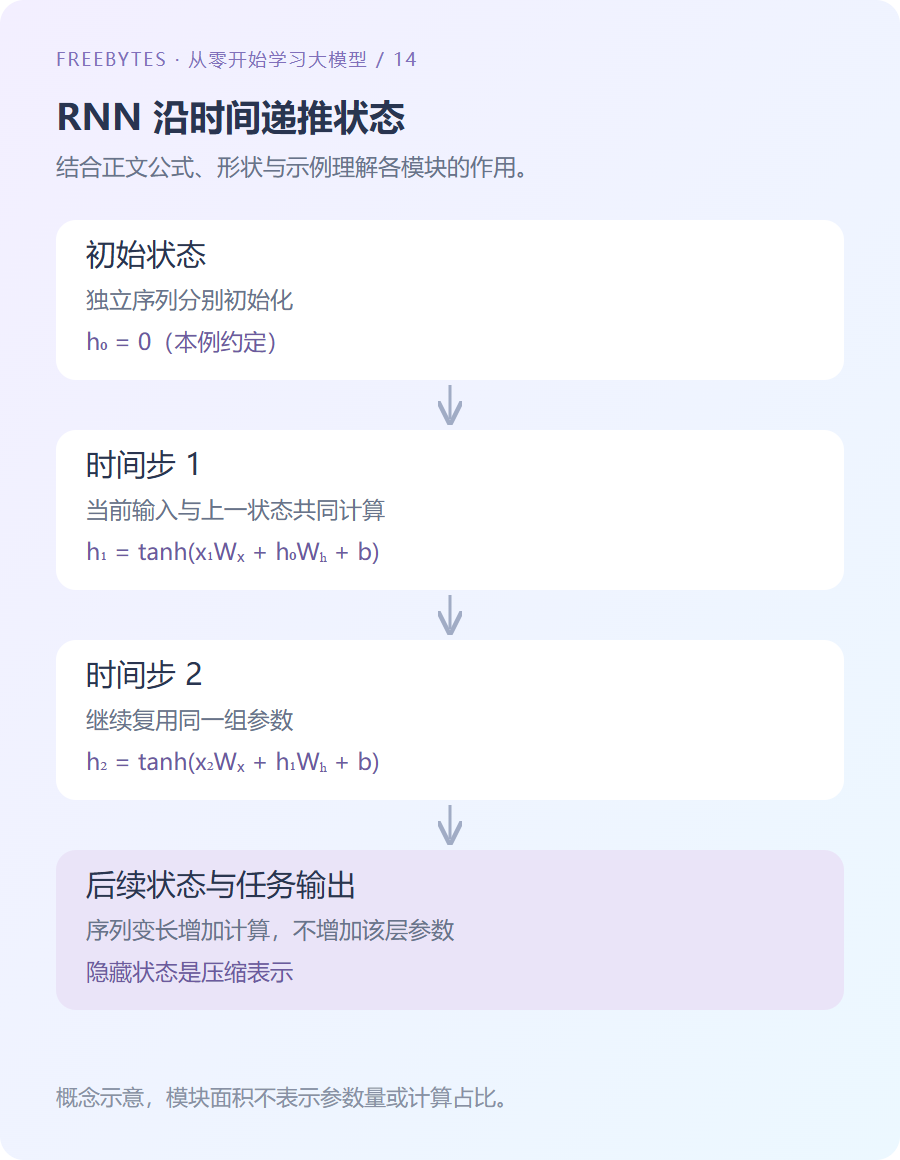
图 1:展开后的节点代表不同时间步,不代表各步拥有独立的循环参数。
2. 参数共享与顺序依赖
同一组 W_x、W_h 和 b 在所有时间步复用,所以序列变长通常不直接增加这一层的参数数量,却会增加计算与保存中间状态的开销。
例如输入维度 3、隐藏维度 4,循环层含 3×4 + 4×4 + 4 = 32 个参数;再接一个两输出的线性头,增加 10 个参数,共 42 个。实际库可能分别存储多个偏置,计数应对应具体实现。
因为本步依赖上一步状态,普通 RNN 的时间递推不便像无循环的层那样同时完成所有位置的状态计算。批次维度和部分矩阵运算仍可并行,不能笼统说整个 RNN 完全不能并行。
3. 一个可运行的标量 RNN
下面把输入和状态都简化为一个数,固定输入权重为 1、循环权重为 0.5、偏置为零。代码展示顺序效应,不执行训练。
from math import tanh, isclose

def run(sequence):
    state = 0.0
    states = []
    for value in sequence:
        state = tanh(value + 0.5 * state)
        states.append(state)
    return states

forward = run([1.0, 0.0, -1.0])
reverse = run([-1.0, 0.0, 1.0])
assert len(forward) == 3
assert all(-1 < x < 1 for x in forward)
assert not isclose(forward[-1], reverse[-1])
assert 3 * 4 + 4 * 4 + 4 + 4 * 2 + 2 == 42
print([round(x, 4) for x in forward])
同样的元素以不同顺序输入,最后状态不同。这说明结构能够利用顺序,但并不证明任意训练后的 RNN 都学会了所需的长期关系。
4. 不同序列任务如何使用输出
| 任务 | 常见输出方式 | 需要注意 |
|---|---|---|
| 整段分类 | 使用最后有效状态或状态池化 | 排除填充位置 |
| 每步标注 | 每个状态产生一个输出 | 对齐输入与标签 |
| 下一步预测 | 当前前缀状态预测后续 | 不应引入未来输入 |
| 编码后生成 | 编码器与解码器组合 | 处理起止符与生成停止条件 |
不同长度序列常被填充到相同长度。需要使用长度信息、掩码或打包序列等方式处理,否则最后状态可能对应填充,而非真实序列末尾。
双向 RNN 可以利用左右两侧上下文,适合允许完整输入的任务;若用于严格在线的下一步预测,未来信息会违反任务条件。
5. 训练为什么涉及时间反向传播
将递推沿时间展开后,仍可使用链式法则求导,通常称为时间反向传播(BPTT)。由于参数共享,来自多个时间步的梯度需要累加。
长链中的多次导数相乘可能使梯度衰减或放大,造成长期依赖学习困难。梯度裁剪可控制过大的梯度,但不能直接恢复已经消失的信号。截断 BPTT 限制反向传播跨度,可降低成本,也会截断部分长期梯度路径。
6. 小结
RNN 通过共享参数递推状态来处理序列,状态大小固定并不等于能够无损保存任意长历史。下一篇介绍 LSTM 如何使用门控与细胞状态改变信息传播方式。
进一步阅读:Dive into Deep Learning:Recurrent Neural Networks。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)