从零开始学习大模型(十五):LSTM 与 GRU 如何改善长期依赖?
普通 RNN 将历史信息反复经过同类非线性变换,长距离信号可能难以保留。LSTM 通过门控和细胞状态提供不同的更新路径,使模型能够学习何时保留、写入和输出信息。
“长期记忆”是结构名称,不代表它能永久保存事实,也不保证所有长序列任务都能有效解决。
1. 两种状态与三个门
常见 LSTM 同时维护细胞状态 c 和隐藏状态 h。门值由当前输入、上一隐藏状态与可训练参数计算,通常经过 Sigmoid;候选写入内容通常经过 tanh。
| 变量 | 常见范围 | 作用 |
|---|---|---|
| 遗忘门 f | 0 到 1 | 调节旧细胞状态的保留比例 |
| 输入门 i | 0 到 1 | 调节候选内容的写入比例 |
| 候选状态 g | −1 到 1 | 提供新内容 |
| 输出门 o | 0 到 1 | 调节对外输出的状态 |
这些变量通常是向量,各分量可以采取不同的更新比例。门不是由开发者逐条编写的离散规则,而是训练得到的连续函数。
2. 核心更新公式
常见、无窥孔连接的 LSTM 可概括为:
f_t、i_t、o_t = sigmoid(各自的输入与隐藏状态线性变换)
g_t = tanh(候选分支的线性变换)
c_t = f_t ⊙ c_(t−1) + i_t ⊙ g_t
h_t = o_t ⊙ tanh(c_t)
⊙ 表示逐元素乘法。细胞状态中的加法路径与普通 RNN 的单一路径不同,是理解该结构的重点。
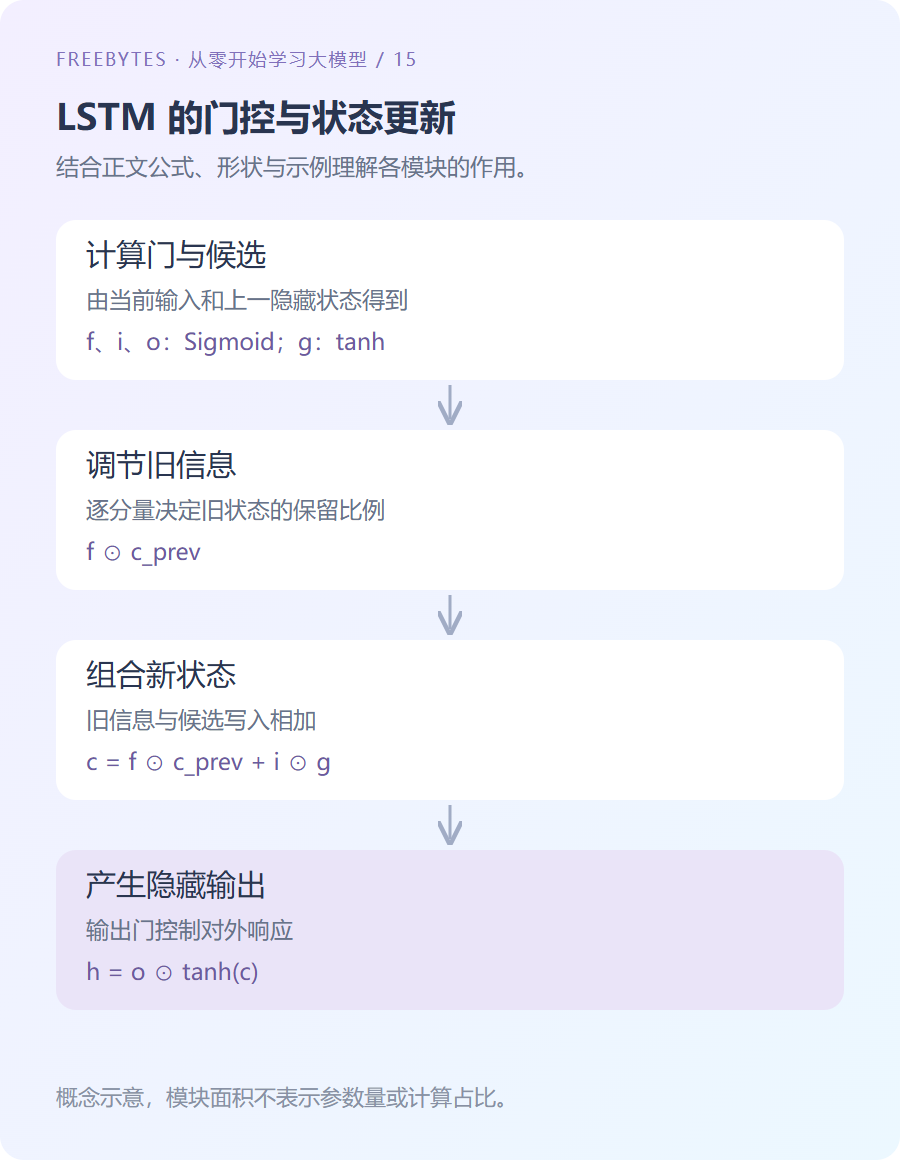
图 1:LSTM 信息流的概念分解,省略各门的权重矩阵与批次轴。
3. 手算一次细胞状态更新
令上一细胞状态为 0.8,f=0.9、i=0.2、g=−0.5、o=0.7。得到 c = 0.9×0.8 + 0.2×(−0.5) = 0.62,再计算 h = 0.7×tanh(0.62)。
from math import tanh, isclose

previous = 0.8
forget, input_gate, candidate, output_gate = 0.9, 0.2, -0.5, 0.7
cell = forget * previous + input_gate * candidate
hidden = output_gate * tanh(cell)
assert isclose(cell, 0.62)
assert abs(hidden) < output_gate
assert 0.99 ** 100 > 0.36
assert 0.5 ** 100 < 1e-29
print(round(cell, 4), round(hidden, 4))
这里的门值是人为指定的教学输入。完整 LSTM 会根据参数计算它们,不能用此代码声称已经实现或训练了完整 LSTM。
4. 为什么这种路径有助于梯度传播
如果暂时将门值视为固定,沿细胞状态直接相连的那条路径,局部导数包含 f。连续 100 次取 0.99 时,其乘积约为 0.366;取 0.5 时则非常小。
这说明门可以形成更有利于保留信号的条件,但完整梯度还包含门对前一隐藏状态等变量的依赖,不应把它简化成唯一的遗忘门乘积。LSTM 仍可能出现梯度问题,也仍需适当的初始化、优化与序列处理。
5. RNN、LSTM 与 GRU 的区别
| 结构 | 状态与门控 | 常见取舍 |
|---|---|---|
| 普通 RNN | 通常一个隐藏状态,无此类显式门控 | 结构较简,长期依赖可能困难 |
| LSTM | 细胞状态与隐藏状态,多组门 | 控制更丰富,参数和计算较多 |
| GRU | 常以更新门、重置门控制隐藏状态 | 结构通常比同宽 LSTM 更紧凑 |
GRU 的公式与实现变体需要具体核对,不能只把 LSTM 的某个门删去就视为等价。模型效果还受隐藏宽度、数据、训练预算与实现影响,没有普遍胜出的结构。
6. 使用时应检查哪些边界
独立序列需要正确管理初始状态,长序列可根据任务切分,但切断梯度与清空状态不是同一操作。变长输入仍需要排除填充的影响。
只使用最后一个状态做整段预测,也可能压缩掉任务所需细节。注意力机制提供了另一种思路:预测时从多个位置选择性聚合信息,而不是全部依赖单个最终状态。
下一篇将介绍这一机制。相关定义可参考 Dive into Deep Learning:LSTM。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
上一篇:RNN 如何处理顺序与历史状态?