从零开始学习大模型(十六):Attention 如何从多个位置聚合信息?
早期序列到序列模型可以用编码器将输入压缩成固定表示,再由解码器生成输出。输入变长后,单个表示可能难以承担所有任务信息。
注意力(Attention)允许预测时访问多个位置的表示,并按当前计算条件加权聚合。它是一种可训练的信息选择与组合机制,不是对人类注意力过程的精确模拟。
1. 查询、键和值分别是什么
| 对象 | 作用 | 需要明确 |
|---|---|---|
| Query(Q) | 提供当前检索条件 | 通常由网络状态投影得到 |
| Key(K) | 与查询计算匹配分数 | 不必等于原始文本或数据库键 |
| Value(V) | 参与最终加权聚合 | 可以与 Key 使用不同投影 |
| 权重 | 将分数归一化 | 依赖查询、键、掩码及计算设置 |
一个查询可以与多个键比较,形成一组分数。对这些分数做 Softmax 后,再对对应 Value 加权求和,得到上下文表示。
2. 从分数到上下文向量
假设某个查询对应两个候选位置,分数为 [0, ln(3)]。Softmax 之后权重为 [0.25, 0.75]。若两个 Value 是 [2,0] 与 [0,4],聚合结果就是 [0.5,3]。
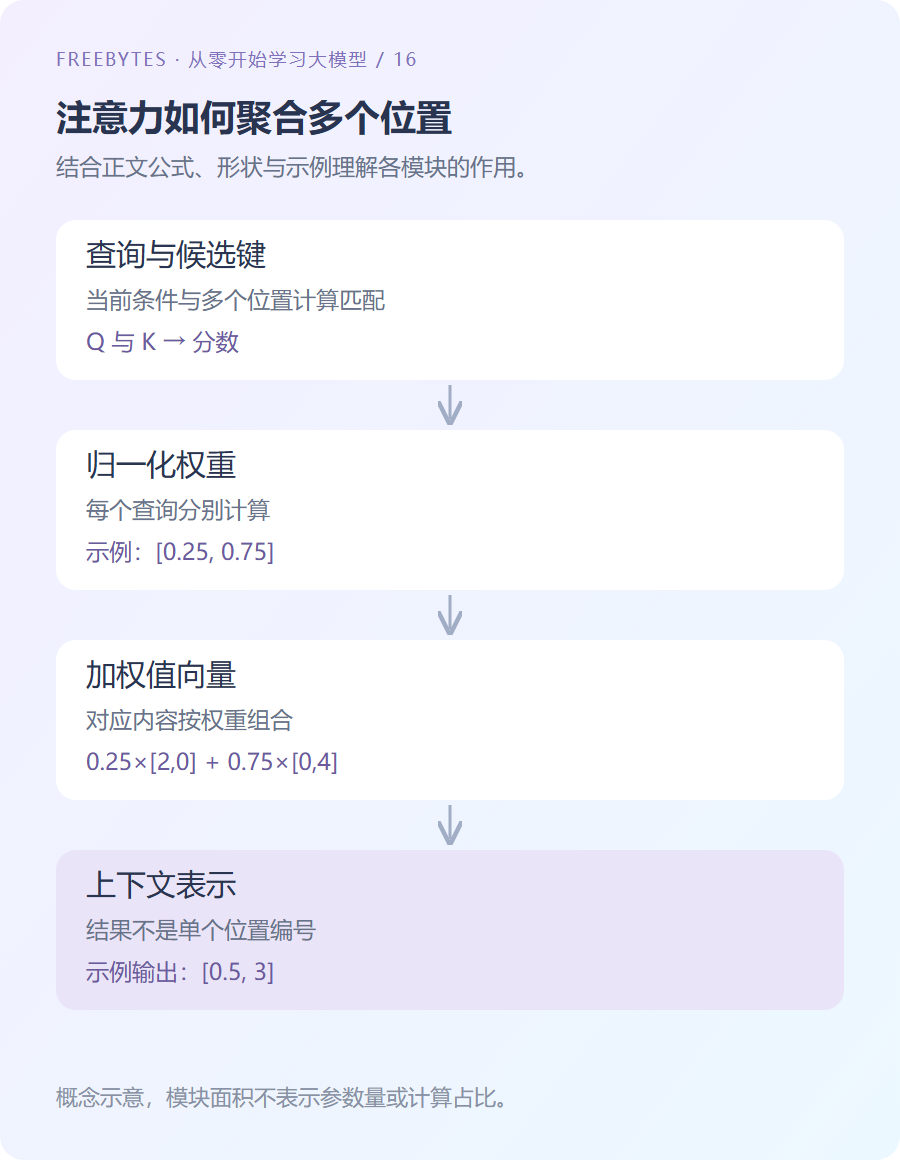
图 1:单个查询的注意力计算。多个查询可以形成多行权重,每行分别归一化。
from math import exp, log, isclose

scores = [0.0, log(3.0)]
maximum = max(scores)
unnormalized = [exp(s - maximum) for s in scores]
weights = [v / sum(unnormalized) for v in unnormalized]
values = [[2.0, 0.0], [0.0, 4.0]]
context = [sum(w * v[j] for w, v in zip(weights, values))
           for j in range(2)]
assert isclose(sum(weights), 1.0)
assert all(isclose(a, b) for a, b in zip(context, [0.5, 3.0]))
print(weights, context)
代码展示归一化与聚合,分数由人工给定;不同注意力机制可以采用加性打分、点积打分等不同方式。
3. 自注意力与交叉注意力
| 类型 | 查询来源 | 键和值来源 |
|---|---|---|
| 自注意力 | 当前序列表示 | 同一序列的表示 |
| 交叉注意力 | 一组表示,例如解码器状态 | 另一组表示,例如编码器输出 |
| 带因果约束的自注意力 | 当前序列位置 | 只允许访问规定的前缀位置 |
“同一序列”不代表 Q、K、V 数值相同。它们可以经过独立的可训练投影。自注意力也不意味着每个位置都能访问全部位置,访问范围需要结合掩码判断。
4. 权重不是自动成立的解释
某个权重较高,只说明它在当前头和当前层的这次聚合中占比较大。输出还受到 Value 内容、残差路径、其他头与后续层影响。
因此不能直接把最高注意力位置当成因果解释,也不能据此判断模型是否使用了可靠证据。可解释性需要结合任务、干预和其他分析,而不是只展示一张热力图。
注意力同样可能聚合无关或错误的信息。掩码设计、训练目标和输入质量决定了它可利用哪些内容,机制名称本身不能保证回答正确。
5. 从序列模型走向 Transformer
传统循环编码器也能与注意力结合。Transformer 的重要变化是以注意力和前馈层组织序列计算,不再依赖相同形式的逐时间步循环状态。
这改变了并行计算方式与长距离位置之间的路径,但也带来注意力矩阵的存储和计算成本。下一阶段将从整体结构开始,再逐步展开 Q/K/V、位置编码和因果生成。
原始加性注意力工作可参考 Neural Machine Translation by Jointly Learning to Align and Translate。