从零开始学习大模型(一):ChatGPT 为什么能回答问题?
大语言模型能够生成文本、解释概念、编写代码,也能根据上下文完成摘要、翻译与问答。这些能力具有共同的技术基础:模型通过训练学习数据中的统计规律,在推理阶段利用上下文逐步生成输出。
对于 GPT 这类自回归语言模型,文字生成的核心是预测下一个 Token。但这一机制如何支持复杂任务,训练与使用模型有何区别,以及为什么回答仍可能出错,需要放在完整的技术框架中理解。
本文是《从零开始学习大模型》系列的第一篇,重点建立概念体系与学习路线,不要求读者预先掌握神经网络或高等数学。后续文章将逐步介绍必要的数学基础、传统机器学习、CNN、RNN、LSTM 和 Transformer。
1. 人工智能、机器学习与大语言模型
**人工智能(Artificial Intelligence,AI)**研究如何通过计算系统完成语言处理、感知、推理和规划等任务。实现这些任务的方法既包括人工设计的规则与搜索算法,也包括从数据中学习的方法。
**机器学习(Machine Learning,ML)**是其中一类方法。以邮件分类为例,开发者可以提供带有类别标签的邮件样本,通过训练调整模型参数,使其根据输入特征判断邮件类别。模型的有效性需要使用未参与训练的数据检验,而不能仅凭训练集上的表现判断。
**深度学习(Deep Learning,DL)**是机器学习的一个分支,主要使用多层神经网络学习数据表示。与依赖人工设计特征的部分传统方法相比,深度学习能够在训练中学习适合任务的多层表示,但仍依赖合适的数据、结构、训练目标与评估方法。
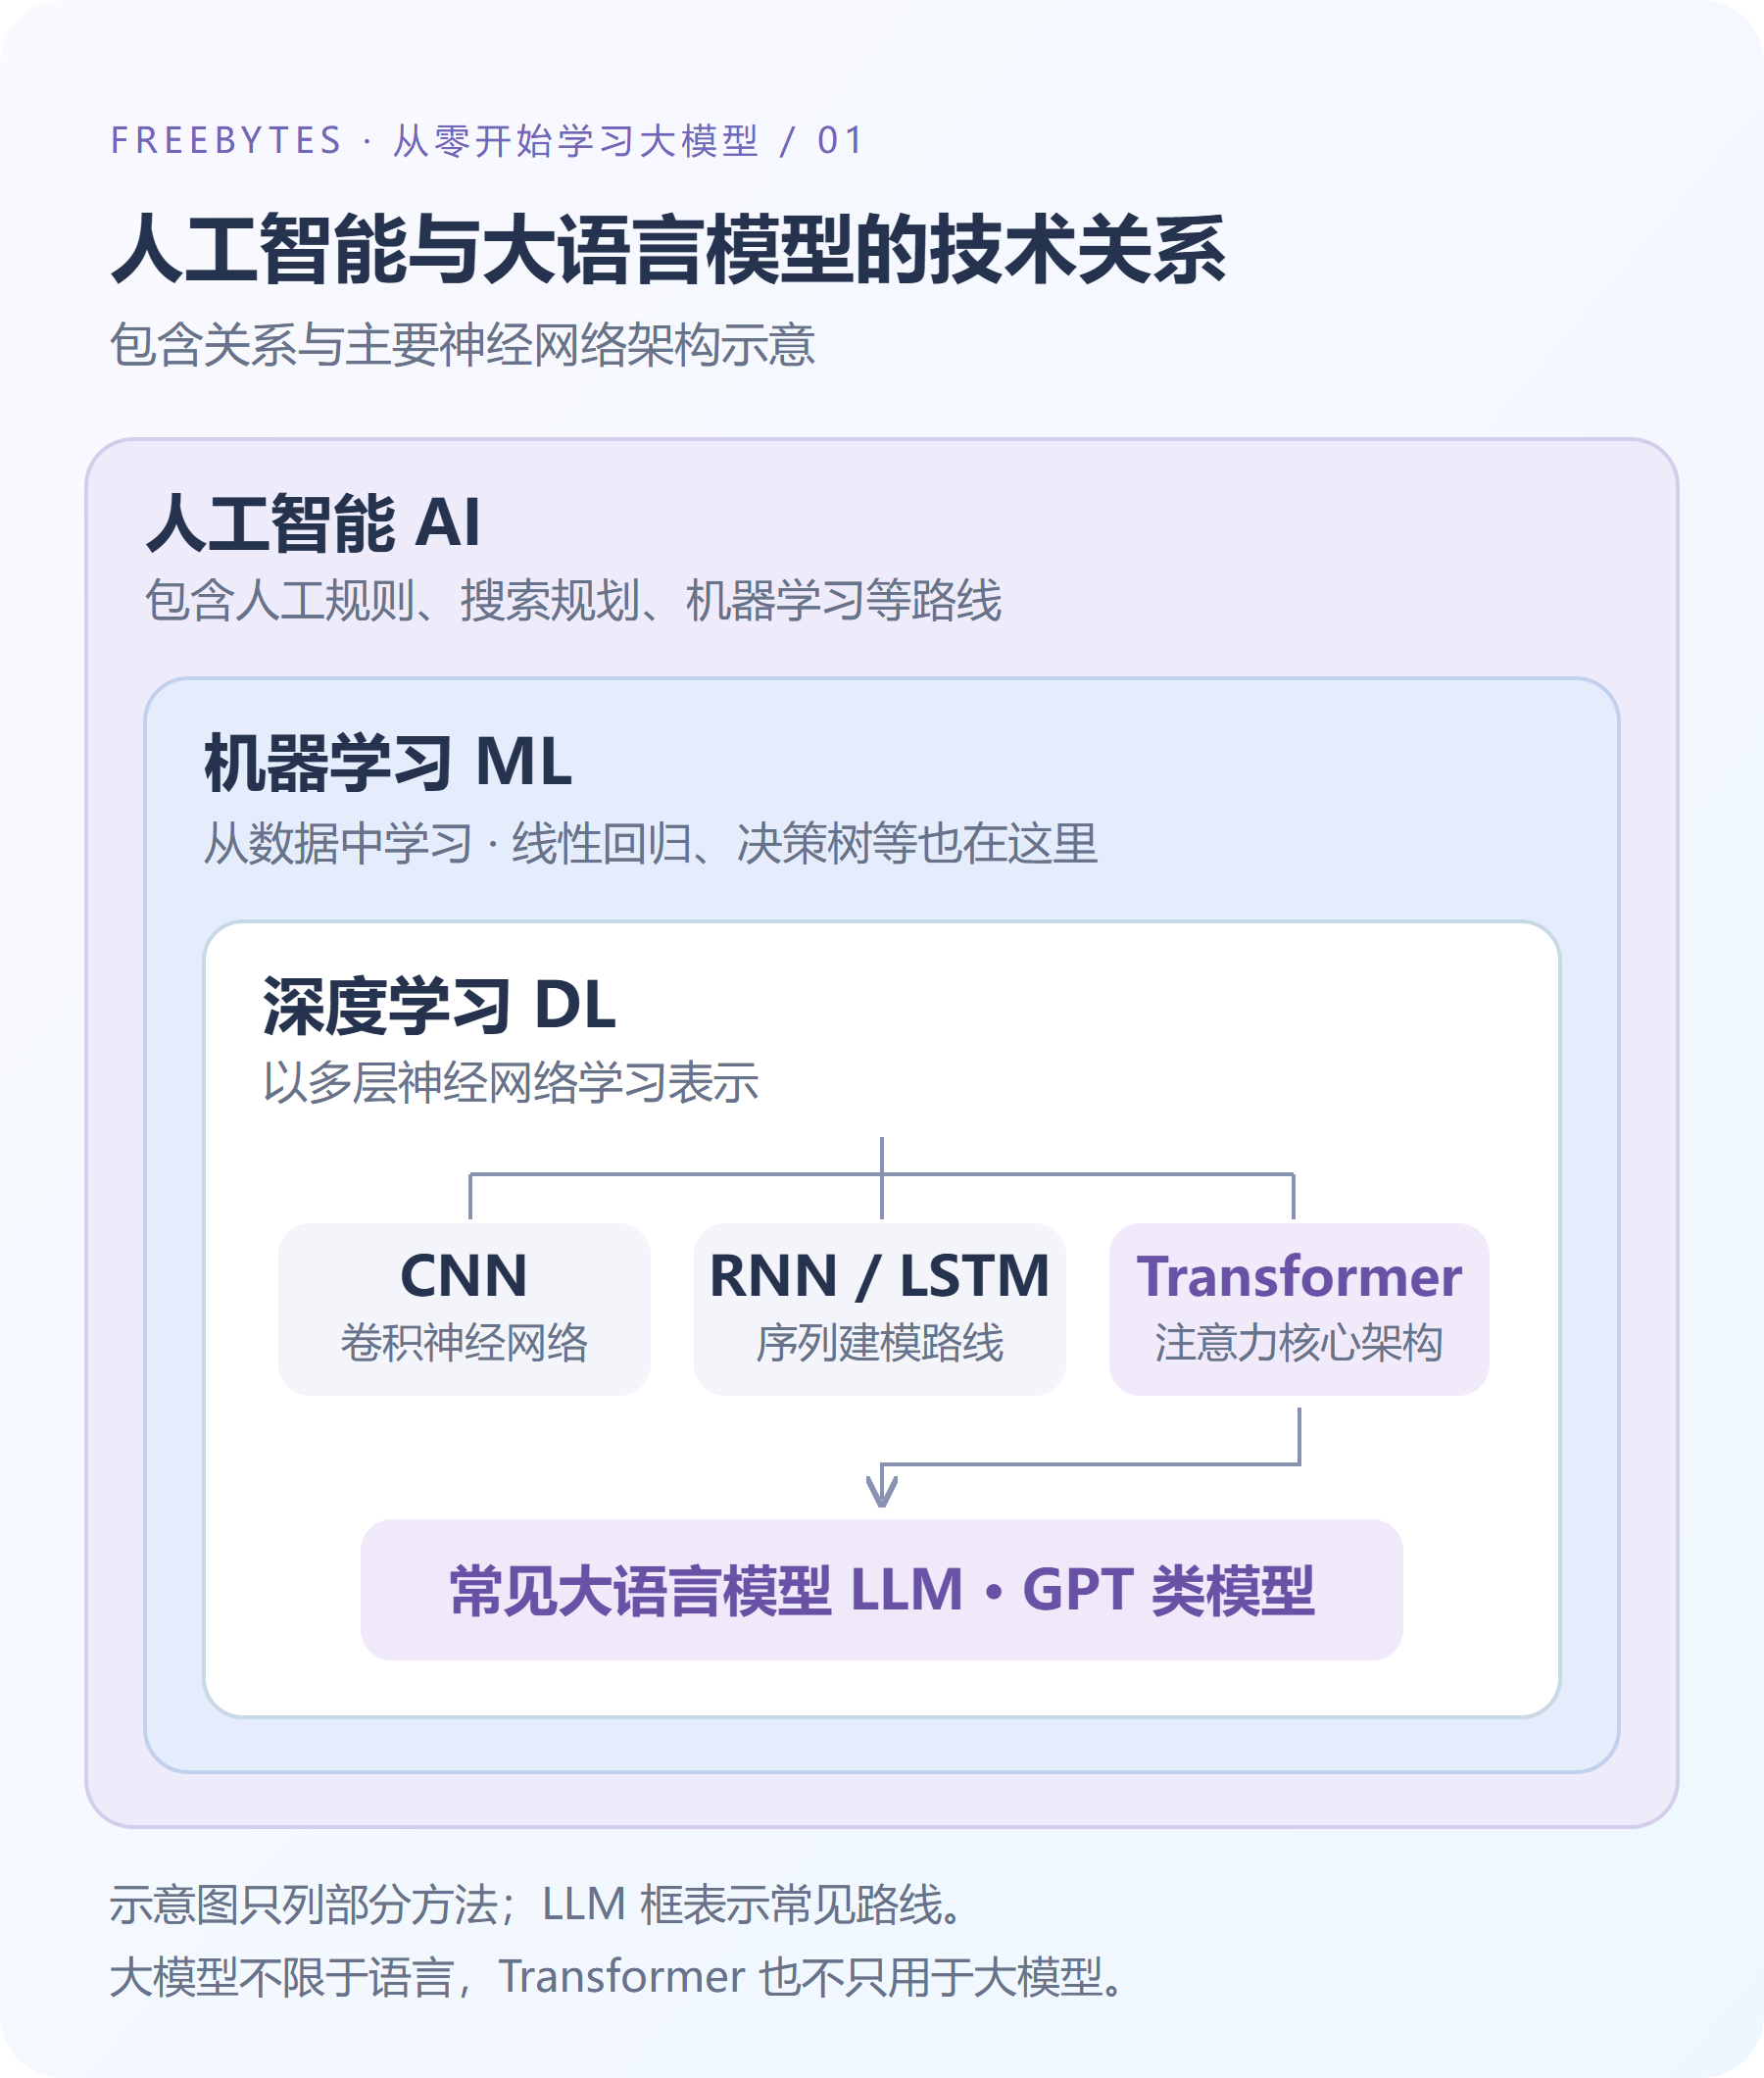
图 1:主要概念与技术路线示意。仅展示部分方法;LLM 的位置表示常见实现路线,并非对所有模型的严格分类。
**大语言模型(Large Language Model,LLM)**通常指在大规模语料上训练、具有较大参数规模的语言模型。“大”没有适用于所有时期和任务的统一参数门槛,也不意味着参数规模可以单独决定模型质量。
常见的生成式大语言模型采用 Transformer 架构,但需要区分三个层次:
- 架构规定模型的计算结构,Transformer 是其中一种。
- 模型包含具体结构及训练得到的参数,决定可执行的计算。
- 产品或应用在模型之外,还可能包含会话管理、检索、工具调用和权限控制。
因此,ChatGPT 这样的对话产品不能与单个语言模型完全等同。此外,大模型也包括图像、语音与多模态模型,范围大于大语言模型。
2. 语言模型如何生成文本
2.1 Token:文本计算的基本单位
模型不能直接对自然语言中的字词进行数值运算,需要先通过分词器将文本转换为 Token 序列,再映射为数值表示。
Token 可能对应一个字、词、词的一部分,或其他文本片段,具体划分取决于分词器。Token 数不等于汉字数,也不等于单词数。 Token 的编号本身只是词表中的索引,其用于计算的向量表示通常通过 Embedding 层获得。
2.2 下一 Token 预测
给定上下文,自回归语言模型计算词表中各个 Token 作为下一个输出的条件概率。选择一个 Token 后,将其追加到序列中,再继续计算后续 Token,直到满足停止条件。
例如,给定文本:
今天天气晴朗,适合到公园
后续内容可能是“散步”,也可能是“跑步”。为便于理解,下表使用文字片段展示候选输出:
| 候选片段 | 示例概率 | 说明 |
|---|---|---|
| 散步 | 55% | 与上下文语义一致 |
| 跑步 | 25% | 另一种合理的活动 |
| 休息 | 15% | 同样可以形成连贯表达 |
| 其他候选合计 | 5% | 其余可能的输出 |
上述概率仅为教学示例,不是实际模型的测量结果。真实预测以 Token 为单位,一个文字片段可能由多个 Token 组成。
整个过程可以概括为:
文本输入 → 分词 → 向量表示 → 模型计算 → 下一 Token 的概率分布 → 选择并追加 → 重复
输出选择取决于解码策略。例如,贪心解码在每一步选择当前概率最高的 Token;采样则按照经过调整的概率分布选择。因此,同一输入可能产生不同输出,局部概率最高的选择也不保证整段回答质量最优。
3. 下一 Token 预测为何能够支持复杂任务
自然语言不仅包含词语搭配,也包含事实陈述、程序结构、逻辑关系与任务示例。要在多样化上下文中降低预测误差,模型需要学习其中可用于预测的规律。
例如,代码生成要求利用变量定义、语法结构与调用关系;摘要要求从已有材料中提取并组织主要信息;解释问题则需要生成与题意、前文和中间步骤相符的内容。
在充分训练的条件下,这一目标可以促进模型形成支持多种任务的内部表示。不过,能力水平受到数据质量、模型结构、训练方法、规模与评估条件等因素共同影响,不能仅由训练目标或参数数量推断。
GPT-3 的研究展示了模型利用提示中的少量示例完成多类任务的能力,即上下文学习(In-context Learning)。这些实验中的任务适配不需要更新模型参数,但在不同任务上的表现存在差异。参见 Language Models are Few-Shot Learners。
下一 Token 预测描述了生成机制,并不能单独回答模型是否具有人类意义上的理解。技术分析更应关注明确任务下的表现、泛化能力、失败条件与可重复的评估结果。
4. 训练与推理的区别
**训练(Training)**通过优化目标调整模型参数。以常见的语言模型预训练为例,训练过程根据上下文预测后续 Token,以实际出现的 Token 作为目标计算损失,再通过反向传播计算梯度,由优化器更新参数。
**推理(Inference)**使用已经得到的参数处理输入并生成输出。普通对话推理通常不更新模型权重,但会使用当前可用的对话历史、系统要求和其他上下文。
| 对比项 | 训练 | 推理 |
|---|---|---|
| 主要目的 | 通过优化目标调整参数 | 使用已有参数完成任务 |
| 参数是否更新 | 通常更新全部或部分可训练参数 | 普通对话推理通常不更新 |
| 输入 | 训练样本及相应训练目标 | 提示、对话历史及其他上下文 |
| 主要计算 | 前向计算、梯度计算与参数更新 | 前向计算与输出生成 |
| 结果 | 训练后的模型参数 | 文本、代码等任务输出 |
在对话中补充要求后,后续回答可能发生变化,是因为输入上下文发生了变化,不能据此判断模型权重已经更新。应用是否保存对话、是否将数据用于后续训练,则需要与当前推理过程分别讨论。
5. 从预训练模型到对话模型
预训练建立语言建模能力,但自然文本中的续写目标与用户希望得到的回答并不总是一致。面向对话的模型通常还需要后训练,以改善指令遵循、回答质量与输出行为。
其中两类常见方法是:
- 监督微调(Supervised Fine-tuning,SFT):使用指令与目标回答等示例,使模型学习按任务要求组织输出。
- 偏好优化:利用回答之间的偏好或反馈调整模型。RLHF 与 DPO 属于后续将介绍的相关路线,两者的训练过程并不相同。
InstructGPT 的研究展示了结合监督微调与人类反馈强化学习的一条具体路线,同时指出,扩大模型规模并不天然改善指令遵循能力。参见 Training language models to follow instructions with human feedback。
实际应用还可以接入搜索、检索增强生成(RAG)或代码执行等工具。语言模型直接生成、根据检索材料生成,以及调用工具后生成,需要分别分析。回答中出现具体事实或参考文献,并不能证明系统执行过检索。
6. 模型能力与事实可靠性的边界
语言模型生成的是在上下文和已学习参数条件下的输出,生成过程本身并不等同于事实核验。
模型可能给出流畅但错误的解释、并不存在的参考文献,或与输入材料不一致的结论。这类生成通常称为幻觉(Hallucination)。其成因可能涉及知识缺失、数据问题、上下文不足和生成过程等多种因素。
对模型输出的评估应结合具体任务:
- 事实问答:核对信息来源、适用范围与时效性。
- 材料摘要:检查是否遗漏关键条件,或引入材料之外的断言。
- 代码生成:通过执行、测试与审查验证功能、边界和安全性。
- 计算与数据分析:复核输入、计算过程和结果,必要时使用确定性的计算工具。
检索和工具调用可以提供外部依据,但不能消除全部错误。系统仍可能检索到不适用的信息、误读材料或错误使用工具。因此,输出是否可靠,应由证据和验证结果判断,而不是由语言的流畅程度判断。
7. 本系列的学习路线
后续内容按照知识依赖逐步展开:
- 数学基础:向量、矩阵、导数、梯度、概率与交叉熵,建立理解模型计算和优化目标所需的基础。
- 传统机器学习:线性回归、逻辑回归与树模型,以及数据划分、过拟合和模型评估。
- 神经网络与 CNN:前向传播、反向传播、训练流程,以及卷积、特征图与残差连接。
- RNN、LSTM 与注意力:序列建模、隐藏状态、长期依赖和注意力机制。
- Transformer:Self-Attention、Q/K/V、多头注意力、位置编码与因果掩码。
- 大模型训练与应用:预训练、后训练、推理优化,以及 RAG、微调与工具调用的适用条件。
这一顺序用于建立知识联系,不表示不同方法之间存在完全替代关系。树模型、卷积网络和循环网络仍有各自的应用条件,需要根据数据、任务、资源与部署要求选择。
Transformer 的原始论文 Attention Is All You Need 提出了一种以注意力机制为核心的序列建模架构。后续文章将在介绍必要基础后,进一步分析其具体结构。
8. 小结
大语言模型的基本过程可以分为两个阶段:训练阶段通过数据与优化目标调整参数,推理阶段根据输入上下文逐步生成输出。预训练、后训练以及外部工具共同影响实际系统的能力,而输出的事实正确性仍需要独立验证。
理解这一框架后,Token、Embedding、梯度和注意力等概念便有了明确的位置。下一篇将从向量与矩阵开始,介绍文本表示与神经网络计算所需的线性代数基础。