从零开始学习大模型(三):导数、梯度与反向传播,模型如何学习?
上一篇介绍了模型如何通过向量和矩阵计算输出。接下来的问题是:模型中的参数应如何确定?
在常见的神经网络训练中,我们先定义一个衡量预测误差的损失函数,再计算损失对参数的变化率,最后由优化器据此调整参数。导数、梯度和反向传播分别描述这一过程中的不同环节。
本文使用一个只有一个可训练参数的例子,完整计算两次更新,再把结论推广到多个参数。理解这个过程,比单独记住优化算法名称更有助于阅读后续模型。
1. 损失函数:把训练目标写成可计算的数
设模型为 ŷ = wx,其中 x 是输入,w 是需要训练的权重,ŷ 是预测值。给定一个教学样本 x = 2、目标值 y = 6,希望通过训练找到合适的 w。
选择平方误差的一种形式作为损失:
L(w) = 1/2 × (wx − y)²
     = 1/2 × (2w − 6)²
系数 1/2 是为了简化求导,不改变这个例子的最优参数位置。这里 w = 3 时,预测为 6,损失为 0。
实际任务通常包含多个样本,需要将样本损失进行求和或平均,并可能加入正则项。损失函数的选择也取决于任务,例如回归常用平方误差,分类常用交叉熵。不能假定所有模型都使用同一种损失。
2. 导数:参数变化时,损失如何变化
对于可导的一元函数,导数描述函数在某一点的局部变化率。对很小的参数变化 Δw,可以近似写成:
L(w + Δw) ≈ L(w) + L'(w) × Δw
这里 L'(w) 表示损失对 w 的导数。若导数为负,局部增大 w 通常可以降低损失;若导数为正,局部减小 w 通常可以降低损失。
“局部”和“小变化”是必要条件。导数只描述当前位置附近的趋势,不能保证任意大小的调整都有效。
对本例求导可得:
dL/dw = (wx − y) × x
      = (2w − 6) × 2
      = 4w − 12
在 w = 0 处,导数是 −12,表示适当增大 w 能降低当前损失。在 w = 3 处,导数为 0。
不过,导数为零不必然表示最小值。其他函数中还可能出现极大值、鞍点或平坦区域,需要结合函数结构判断。
3. 梯度下降:沿降低损失的方向更新参数
最基本的梯度下降更新规则为:
w_new = w_old − η × dL/dw
η 是学习率,控制这一步的更新幅度。负号表示沿导数或梯度的反方向更新,而不是将参数直接减去损失值。
令初始值 w₀ = 0,学习率 η = 0.1。第一次更新如下:
梯度:4 × 0 − 12 = −12
新参数:0 − 0.1 × (−12) = 1.2
新预测:1.2 × 2 = 2.4
新损失:1/2 × (2.4 − 6)² = 6.48
第二次更新后,w 变为 1.92,预测变为 3.84,损失降至 2.3328。
| 参数状态 | 权重 w | 预测 ŷ | 损失 L | 当前梯度 |
|---|---|---|---|---|
| 初始 | 0 | 0 | 18 | −12 |
| 更新一次 | 1.2 | 2.4 | 6.48 | −7.2 |
| 更新两次 | 1.92 | 3.84 | 2.3328 | −4.32 |
| 理论最优 | 3 | 6 | 0 | 0 |
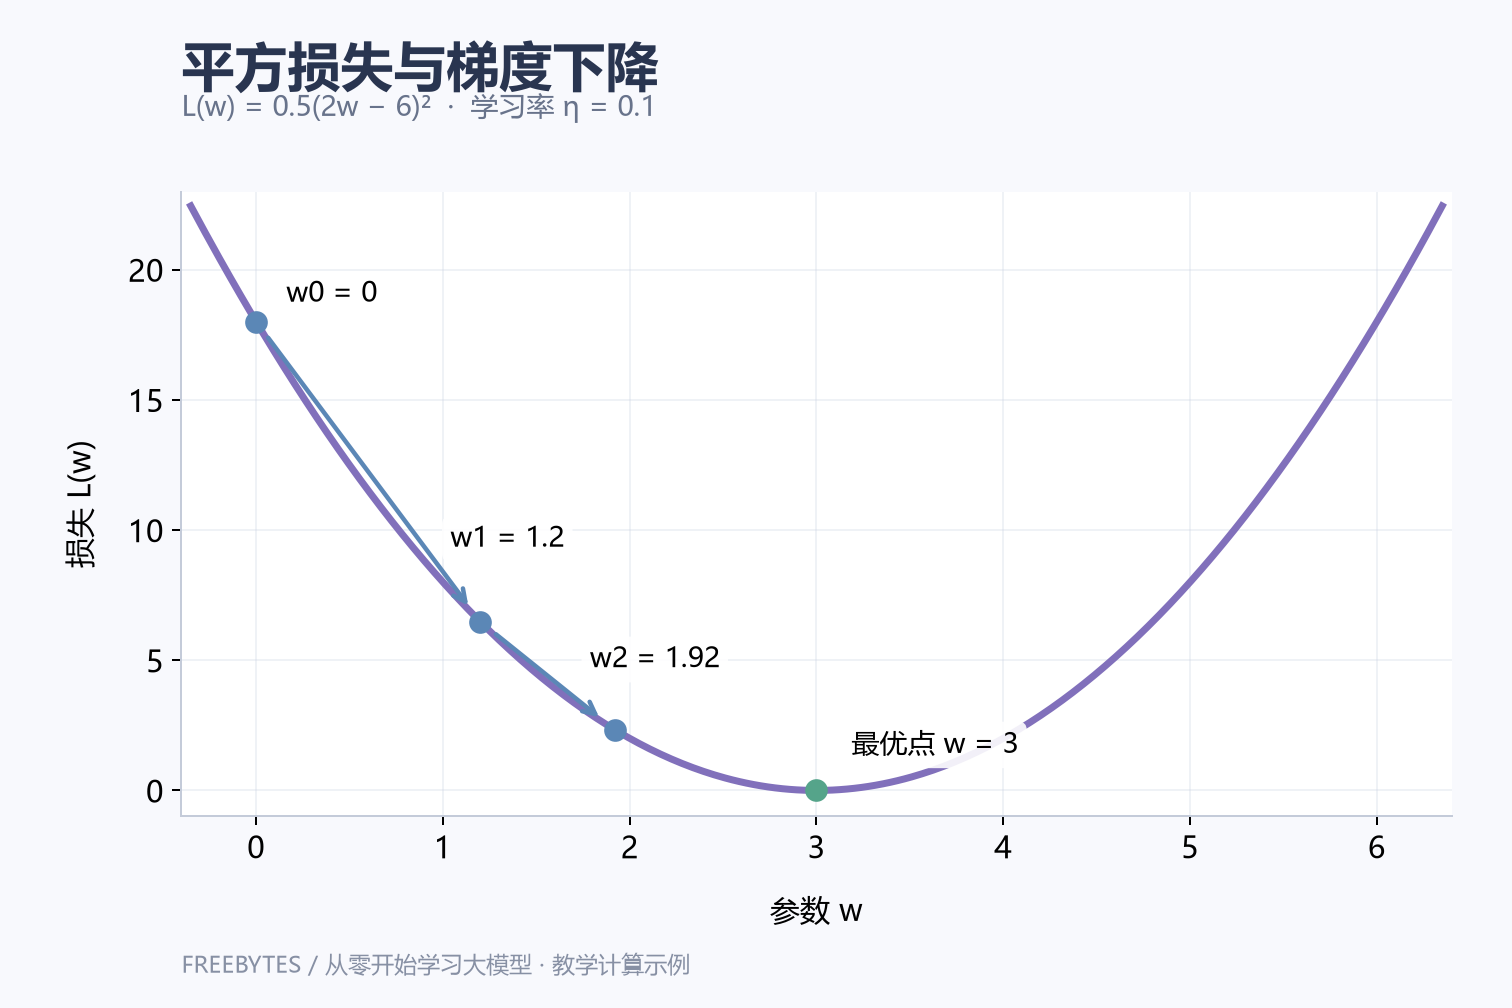
图 1:本文示例的真实函数曲线与更新位置。该凸函数具有明确最小值,不代表深度网络的一般损失形状。
4. 多个参数:偏导数与梯度
如果模型改为 ŷ = wx + b,损失同时依赖权重 w 和偏置 b。
偏导数描述固定其他参数时,函数对某一个参数的变化率。记号 ∂L/∂w 与 ∂L/∂b 分别表示损失对两个参数的偏导数。
对于 L = 1/2 × (wx + b − y)²:
∂L/∂w = (wx + b − y) × x
∂L/∂b = wx + b − y
**梯度(Gradient)**将各参数的偏导数组合成向量。对于参数向量 θ = [w, b],有 ∇L = [∂L/∂w, ∂L/∂b],更新写成 θ_new = θ_old − η∇L。
在欧几里得距离约束下,非零梯度指向函数在当前位置增长最快的方向,负梯度则给出局部下降方向。深度网络中的权重可能是矩阵或更高阶张量,对应梯度具有相同的形状。
5. 链式法则与反向传播
神经网络的输出由多步计算组成。求参数梯度时,需要沿这些依赖关系组合局部导数,这就是链式法则的作用。
将最初的例子拆成:
z = wx
e = z − y
L = 1/2 × e²

dL/dw = (dL/de) × (de/dz) × (dz/dw)
      = e × 1 × x
如果一个参数通过多条路径影响损失,需要把各路径的贡献相加。反向传播利用计算图,从损失向前面的计算节点传播梯度,并复用中间结果,以高效计算大量参数的导数。
反向传播负责计算梯度,优化器负责使用梯度更新参数。 两者不能等同。梯度下降、带动量的方法和 Adam 等优化器,可以使用相同的反向传播结果,但采用不同的更新规则。
| 概念 | 主要问题 | 在训练中的作用 |
|---|---|---|
| 损失函数 | 预测误差如何度量 | 给出优化目标 |
| 导数与偏导数 | 改变一个变量有什么局部影响 | 计算变化率 |
| 梯度 | 所有参数的变化率如何组织 | 提供更新依据 |
| 反向传播 | 如何高效算出这些梯度 | 在计算图上应用链式法则 |
| 优化器 | 根据梯度如何调整参数 | 执行更新规则 |
6. 学习率为什么重要
在本例中,学习率较小可能需要更多步才能接近最优点;过大则可能在两侧振荡,甚至使损失持续增大。
这说明更新方向正确,也不保证更新幅度合适。深度学习训练通常需要结合初始化、数据尺度、批次大小和优化器选择学习率,有时还会随训练进度调整。
此外,还应区分:
- 全批量梯度下降:一次更新使用整个训练集的梯度。
- 随机梯度下降:狭义上一次使用一个样本,实际讨论中也常泛指带随机性的批量方法。
- 小批量训练:一次使用一部分样本,是常见的神经网络训练方式。
小批量梯度存在采样噪声,因此训练中的单步损失不必严格下降。前面单样本凸函数的平滑下降结果,不能直接推广到每一个实际训练步骤。
7. 用 Python 验证两次更新
以下代码只依赖 Python 标准库。梯度来自前面的手工推导,暂不使用自动微分,以便对应每一步数学计算。
from math import isclose

x, y = 2.0, 6.0
w, learning_rate = 0.0, 0.1

for step in range(2):
    prediction = w * x
    gradient = (prediction - y) * x
    w -= learning_rate * gradient
    loss = 0.5 * (w * x - y) ** 2
    print(step + 1, round(w, 4), round(loss, 4))

assert isclose(w, 1.92)
assert isclose(loss, 2.3328)
输出为 1 1.2 6.48 和 2 1.92 2.3328。后续使用自动微分框架时,框架可以代替手工计算梯度,但损失、求导对象与更新顺序仍需要明确。
8. 损失下降并不等于模型已经有效
训练损失下降,只说明模型在选定目标和训练数据上的拟合有所改善,不保证对新数据同样有效。
评估还需要关注验证集表现、过拟合、数据泄漏和任务指标。深度网络的损失通常是非凸的,基础梯度下降也不能普遍保证找到全局最优解。自动微分可以计算程序对应的导数,却不能替代对目标函数与数据的正确设计。
本篇建立了“定义损失—计算梯度—更新参数”的基本流程。下一篇将介绍概率、似然与交叉熵,解释语言模型如何将实际出现的 Token 转化为训练信号。
关于导数、偏导数和链式法则,可进一步阅读 Dive into Deep Learning:Calculus。