从零开始学习大模型(四):概率、似然与交叉熵,如何衡量预测误差?
语言模型通常不会直接输出“答案是否正确”的评分,而是在每一步生成时计算词表中各个 Token 的概率。训练则需要将这一概率分布与实际目标联系起来,形成可以优化的损失。
上一篇介绍了梯度如何更新参数,本篇解释其中的目标函数:概率描述什么,似然从哪个角度使用概率,Softmax 如何得到分布,以及交叉熵为什么适合常见的分类和语言建模任务。
以下主要讨论离散事件与类别分布,公式中的 ln 均表示自然对数。
1. 概率分布与条件概率
对于一个取值有限的随机变量,每个可能结果对应一个非负概率,所有结果的概率之和为 1。例如,一个简化的天气变量可以取“晴”“阴”“雨”三个互斥值,对应概率为 [0.6, 0.3, 0.1]。
概率分布描述在给定建模条件下结果的不确定性。某个结果的概率最高,不意味着它一定发生;单次结果未发生,也不能单独证明概率估计无效,需要结合多次观测与评估方法判断。
条件概率描述在已知某个条件后,事件发生的概率。若 P(B) > 0,定义为:
P(A | B) = P(A ∩ B) / P(B)
A ∩ B 表示两个事件同时发生,竖线 | 表示“在……条件下”。一般而言,P(A | B) 与 P(B | A) 不相等。
语言模型使用的正是条件概率。给定已有 Token 序列,模型计算下一个 Token 的分布。改变上下文,即改变条件,输出分布也可能变化。
2. 贝叶斯公式:区分不同方向的条件概率
贝叶斯公式为:
P(A | B) = P(B | A) × P(A) / P(B)
其中 P(A) 是先验概率,P(B | A) 描述假定 A 成立时观察到 B 的概率,P(A | B) 是纳入 B 这一信息后的后验概率。
考虑一个完全用于教学的邮件分类例子:1000 封邮件中有 10 封垃圾邮件。分类器能标记其中 90%,但也会误标正常邮件中的 10%。按这些假设计算:
实际垃圾邮件:10 封,其中 9 封被标记
实际正常邮件:990 封,其中 99 封被误标
全部被标记邮件:9 + 99 = 108 封

P(垃圾邮件 | 被标记) = 9 / 108 ≈ 8.33%
这与 P(被标记 | 垃圾邮件) = 90% 是不同的量。由于正常邮件占绝大多数,即使误标比例并不超过 10%,也会产生较多误报。判断分类器表现时,基础发生率与错误类型都很重要。
该例说明条件概率的方向不能交换,不表示语言模型每一步生成都在显式执行这个贝叶斯计算。
3. 概率与似然:同一表达式的不同视角
设一个简化模型每次独立输出 A 或 B,A 的概率为参数 θ,B 的概率为 1 − θ。
- 固定
θ,讨论可能观察到哪些数据,使用的是概率视角。 - 固定已经观察到的数据,比较不同
θ对这些数据的支持程度,使用的是似然视角。
若观察到有序结果 A、A、B,其似然函数为:
L(θ) = θ × θ × (1 − θ) = θ²(1 − θ)
θ = 0.5 时,似然为 0.125;θ = 2/3 时,似然约为 0.1481。在这个模型与观测条件下,最大似然估计为 2/3。
似然是关于参数的函数,但不自动成为参数的概率分布。 若要讨论“参数取某个值的后验概率”,还需要先验等额外建模条件。
语言模型中的序列不能简单按独立 Token 处理。依据概率的链式法则,一个序列的概率可以分解为每个 Token 在此前上下文条件下的概率乘积;这种分解不要求各 Token 相互独立。
取对数后,乘积变成求和。最大化对数似然,就等价于最小化负对数似然,这为训练目标提供了基础。
4. Softmax:从分数到概率分布
神经网络通常先产生一组未归一化分数,称为 logits。这些分数可以为负,也不要求总和为 1。
对于类别分数 z₁, z₂, …, zₖ,Softmax 定义为:
qᵢ = exp(zᵢ) / Σⱼ exp(zⱼ)
Σ 表示对指定范围求和,exp(z) 表示自然指数函数。对有限 logits,Softmax 的各项为正、总和为 1。
例如 [2, 1, 0] 经过 Softmax,约为 [0.6652, 0.2447, 0.0900]。原始分数不能直接解释为概率,分数之间的相对差异通过指数与归一化影响最终分布。
实际计算常先减去最大分数,再做指数运算。这不改变 Softmax 的数学结果,却可以降低指数溢出的风险。
Softmax 使输出成为合法的类别分布,但不保证概率已经校准,也不保证高概率结果符合事实。在语言模型中,Token 概率与“整个回答正确的概率”属于不同层次。
5. 熵:分布自身的不确定性
对于离散分布 p,熵的定义为:
H(p) = −Σᵢ pᵢ ln(pᵢ)
其中 0 × ln(0) 按极限取 0。使用自然对数时,单位为 nat;使用以 2 为底的对数时,单位为 bit。
对于两个可能结果,均匀分布 [0.5, 0.5] 的熵约为 0.6931,较集中的分布 [0.9, 0.1] 的熵约为 0.3251。在固定类别数量下,均匀分布具有最大熵。
熵低表示分布更集中,不代表预测更正确。模型完全可能给错误类别分配很高的概率,同时具有较低的输出熵。
6. 交叉熵:目标分布与模型预测之间的代价
设 p 为目标分布,q 为模型预测分布,交叉熵定义为:
H(p, q) = −Σᵢ pᵢ ln(qᵢ)
常见的单标签分类使用 one-hot 目标:正确类别的位置为 1,其余位置为 0。此时交叉熵简化为 −ln(q_correct),即正确类别预测概率的负对数。
| 分给正确类别的概率 | 单样本交叉熵 | 含义 |
|---|---|---|
| 0.9 | 约 0.1054 | 模型给目标类别较高概率 |
| 0.5 | 约 0.6931 | 对目标类别的支持较弱 |
| 0.1 | 约 2.3026 | 目标类别获得较低概率,惩罚更大 |
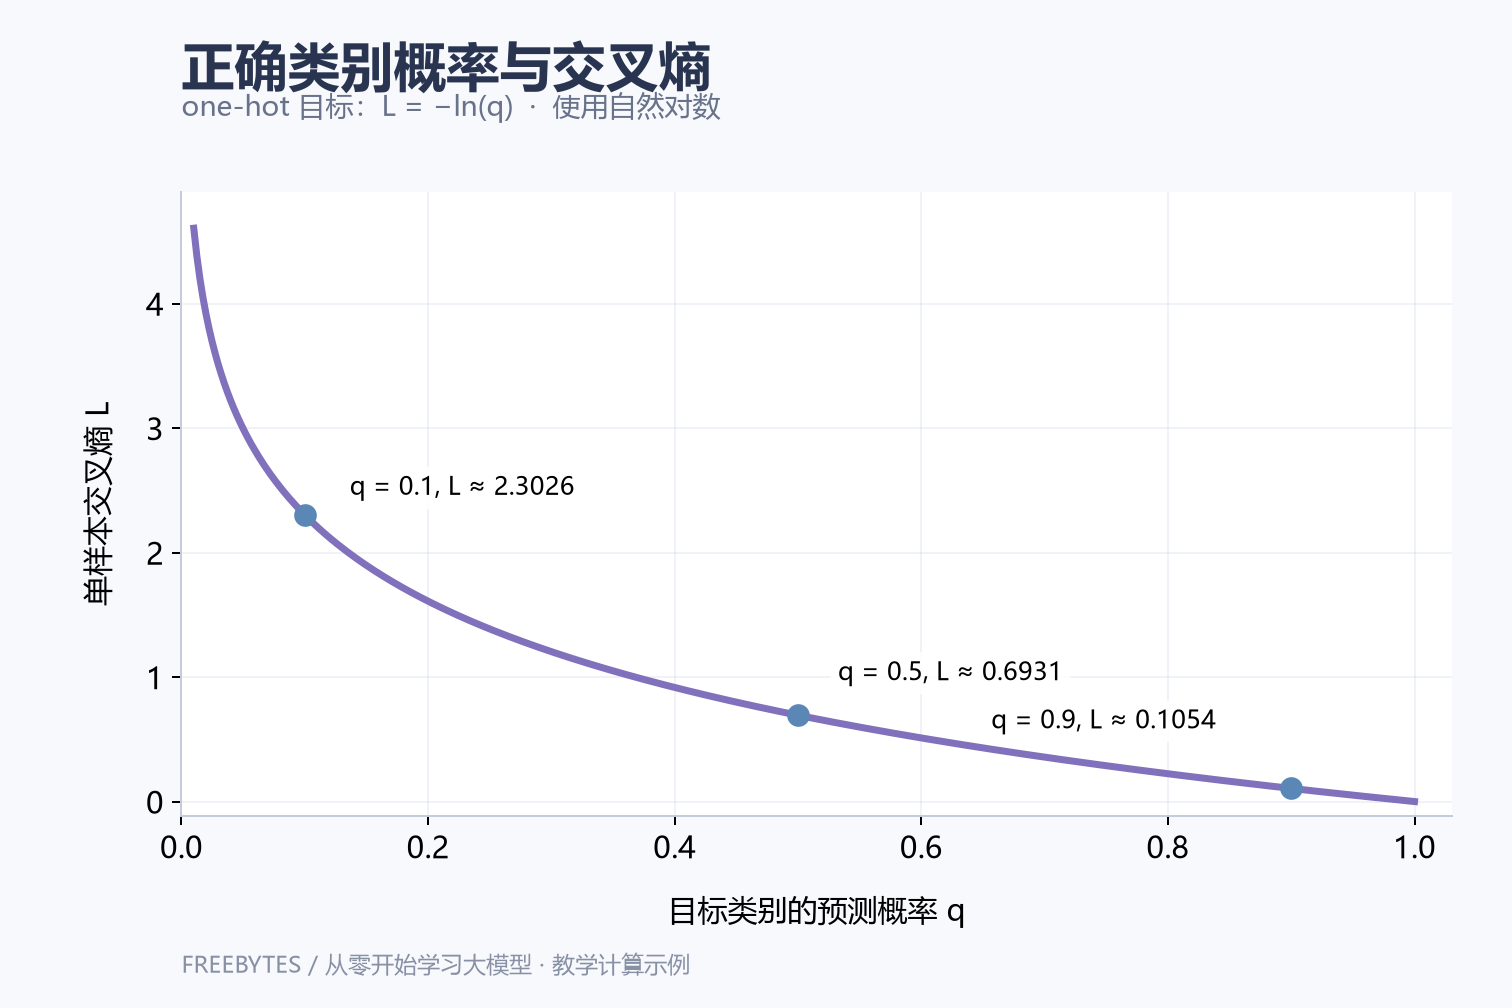
图 1:one-hot 目标下的损失 −ln(q_correct)。图中只绘制概率大于零的区间;概率趋近零时损失趋于无穷。
从整个分布看,交叉熵可分解为 H(p, q) = H(p) + D_KL(p || q)。目标分布固定时,最小化交叉熵相当于最小化这个方向的 KL 散度;KL 散度不是对称距离。
如果目标分布对某类分配正概率,而模型给该类零概率,交叉熵将为无穷。实现中需要注意浮点下溢,并使用数值稳定的 log-softmax 或交叉熵函数,而不是对已经下溢为零的数直接取对数。
7. 下一 Token 预测如何形成训练损失
在常见的自回归预训练中,模型在每个位置依据前文预测下一个 Token,训练数据中实际出现的下一个 Token 作为目标标签。将所选训练位置的交叉熵求和或平均,就形成训练损失。
例如,某三个位置的目标 Token 概率分别为 0.9、0.5、0.1,平均负对数损失约为:
平均损失 = [−ln(0.9) − ln(0.5) − ln(0.1)] / 3
         ≈ 1.0337
这里每个位置的概率都基于对应上下文,目标只是训练文本中实际出现的 Token,不意味着它是所有语境下唯一合理的表达。
训练时还需要明确哪些位置计入损失:填充位置通常被忽略,部分指令训练也会只对选定的回答位置计算损失。平均方式和掩码不同,损失数值就不能直接比较。
困惑度(Perplexity)常定义为平均 Token 负对数损失的指数,即 exp(平均损失)。使用这一指标比较模型,需要控制分词器、测试数据和损失统计规则等条件,不能直接跨不同设置判断优劣。
8. 一个可运行的计算示例
下面使用 Python 标准库计算三类别 Softmax 和 one-hot 交叉熵。通过 log-sum-exp 计算对数归一化项,避免先对极小概率取对数。
from math import exp, log, isclose

logits = [2.0, 1.0, 0.0]
target = 0
maximum = max(logits)
shifted = [value - maximum for value in logits]
denominator = sum(exp(value) for value in shifted)
probabilities = [exp(value) / denominator for value in shifted]
loss = log(denominator) - shifted[target]

assert isclose(sum(probabilities), 1.0)
assert isclose(loss, 0.4076059644, rel_tol=1e-9)
print([round(p, 4) for p in probabilities])
print(round(loss, 4))
结果约为 [0.6652, 0.2447, 0.09] 与 0.4076。框架中的交叉熵函数通常接收 logits,使用时应核对接口,避免错误地重复应用 Softmax。
9. 第一阶段小结
| 概念 | 主要作用 | 不应混淆的对象 |
|---|---|---|
| 条件概率 | 在给定信息下描述结果分布 | 条件交换后的概率 |
| 似然 | 固定数据,比较不同参数 | 参数自身的概率分布 |
| Softmax | 将类别分数归一化为分布 | 事实正确性的保证 |
| 熵 | 描述分布自身的不确定性 | 预测是否正确 |
| 交叉熵 | 度量目标分布下的预测代价 | 任务质量的全部指标 |
至此,第一阶段形成了一个基本闭环:向量与矩阵表示和变换数据,概率分布描述候选输出,损失函数衡量预测代价,梯度与优化器负责调整参数。
第二阶段将从线性回归开始,把数据、模型、训练与评估组织成完整的机器学习流程。概率与分类目标的进一步解释,可参考 Dive into Deep Learning:Probability and Statistics 与 Softmax Regression。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
下一篇:线性回归,机器学习到底在学什么?