从零开始学习大模型(五):线性回归,机器学习到底在学什么?
第一阶段介绍了向量、梯度和概率,第二阶段将这些概念组织成完整的机器学习流程。线性回归适合作为起点:模型结构简单,参数含义清晰,训练结果可以手工验证。
以根据面积预测房价为例,开发者不需要事先给每套房屋写定价规则,而是提供历史样本,选择模型与损失函数,再通过训练确定参数。真正需要检验的是:这些参数能否用于未参与训练的数据。
1. 样本、特征和标签
一个监督学习样本通常包含输入特征与目标标签。面积、楼龄和位置可以是特征,待预测的成交价格则是标签。回归任务的目标通常是连续数值;分类任务的目标是离散类别。
本文使用下表中的四个训练样本。数值经过人工构造并省略物理单位,仅用于演示计算,不代表真实房地产市场。
| 训练样本 | 输入特征 x | 目标值 y |
|---|---|---|
| 1 | 1 | 3.2 |
| 2 | 2 | 4.9 |
| 3 | 3 | 7.1 |
| 4 | 4 | 9.0 |
特征必须与实际预测时可获得的信息一致。例如,要预测成交前的价格,就不能使用事后才能知道的最终成交费用作为输入。否则可能出现数据泄漏,离线评估高估实际效果。
2. 用一条直线表达预测规则
一元线性回归写成:
ŷ = wx + b
x 是输入,ŷ 是预测,w 是权重,b 是截距或偏置。对于确定的模型与输入,参数确定后就可以计算输出。
多个特征时,模型扩展为 ŷ = w₁x₁ + … + w_dx_d + b。样本按行组织后,可以写成矩阵形式 ŷ = Xw + b,与第二篇介绍的矩阵运算对应。
“线性”主要指对待估参数的线性关系。例如 ŷ = w₁x + w₂x² + b 对输入可以形成曲线,但对参数仍然线性。引入高次特征会改变模型的表达能力,也可能增加过拟合风险。
3. 用损失函数确定参数
对于有 n 个样本的数据,均方误差为:
MSE = (1/n) × Σᵢ(ŷᵢ − yᵢ)²
它对较大的偏差给予更大惩罚,因此异常值可能显著影响拟合结果。平均绝对误差 MAE 使用绝对值而非平方,具有不同的误差偏好,不能仅凭名称选择损失。
最小二乘法通过最小化平方误差确定参数。一元、有截距且输入存在变化时,解可以写成:
w = Σᵢ(xᵢ − x_mean)(yᵢ − y_mean)
    / Σᵢ(xᵢ − x_mean)²
b = y_mean − w × x_mean
本例 x_mean = 2.5,y_mean = 6.05,分母为 5,分子为 9.8,因此 w = 1.96、b = 1.15。预测规则为 ŷ = 1.96x + 1.15。
如果所有输入完全相同,分母为零,不能使用上述公式唯一确定斜率。多特征模型也可能遇到共线性等问题。数值库通常使用稳定的矩阵分解方法求解,不应直接把显式求逆当作通用实现方案。
梯度下降同样可以优化这个损失,它逐步更新参数;闭式解则利用问题结构直接求解。两者服务于相同目标,但计算方式与资源需求不同。
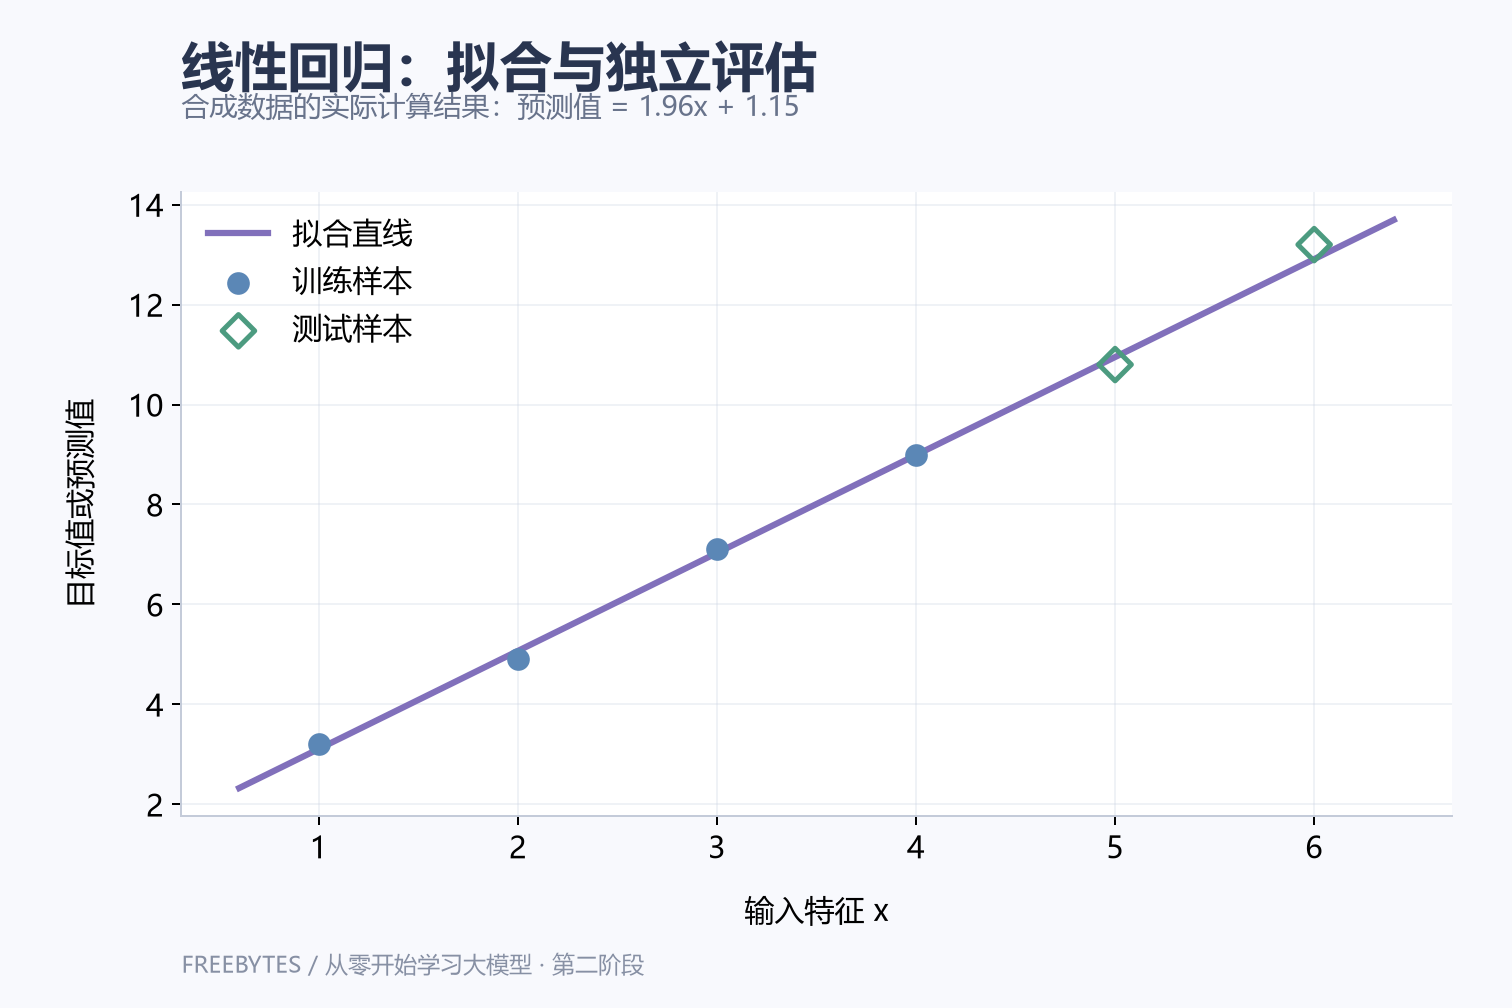
图 1:由本文给定数据实际计算的最小二乘拟合。测试点未参与参数求解;少量合成样本不能证明真实任务中的泛化能力。
4. 训练完成后,如何评价结果
另给两个未参与拟合的测试样本:(5, 10.8) 与 (6, 13.2)。模型预测分别为 10.95 与 12.91,预测减去目标的误差为 0.15 与 −0.29。
因此测试集 MSE 为 0.0533,MAE 为 0.22。MSE 的单位是目标单位的平方,MAE 与目标具有相同单位;RMSE 是 MSE 的平方根,也回到目标的原单位。
| 指标或对象 | 作用 | 需要注意 |
|---|---|---|
| 训练损失 | 衡量拟合训练数据的程度 | 低训练误差不保证泛化 |
| 验证集表现 | 选择模型、特征与超参数 | 反复选择也可能过拟合验证集 |
| 测试集表现 | 对最终方案做独立评估 | 不用于反复调参 |
| MAE | 反映平均绝对偏差 | 应结合目标单位解释 |
| RMSE | 对大偏差更敏感 | 易受少量大误差影响 |
本例的测试输入还超出了训练输入范围,属于外推。即使这里误差较小,也不能认为实际数据会沿同一条直线延伸。真实任务需要符合使用场景的数据划分、更多样本和恰当的基线。
5. 一个完整的可运行示例
下面使用 Python 标准库,先拟合训练集,再对固定测试集评估。测试标签只在参数确定后用于计算误差。
from math import isclose

train_x = [1.0, 2.0, 3.0, 4.0]
train_y = [3.2, 4.9, 7.1, 9.0]
x_mean = sum(train_x) / len(train_x)
y_mean = sum(train_y) / len(train_y)
numerator = sum((x - x_mean) * (y - y_mean)
                for x, y in zip(train_x, train_y))
denominator = sum((x - x_mean) ** 2 for x in train_x)
w = numerator / denominator
b = y_mean - w * x_mean

test_x, test_y = [5.0, 6.0], [10.8, 13.2]
errors = [w * x + b - y for x, y in zip(test_x, test_y)]
mse = sum(e ** 2 for e in errors) / len(errors)
mae = sum(abs(e) for e in errors) / len(errors)
assert isclose(w, 1.96) and isclose(b, 1.15)
assert isclose(mse, 0.0533) and isclose(mae, 0.22)
print(round(w, 4), round(b, 4), round(mse, 4))
这段示例假定列表非空、长度匹配且输入具有变化。生产实现还需要检查缺失值、异常输入和数值稳定性。
6. 从计算示例到实际建模
实际工作中,应先明确预测时点、目标和数据来源,再进行以下步骤:
- 按真实使用场景划分训练、验证和测试数据。
- 只用训练数据拟合缺失值处理、编码和缩放规则。
- 建立简单基线,例如始终预测训练标签的均值。
- 训练候选模型,用验证数据选择方案。
- 固定方案后评估测试集,分析不同群体与误差区间。
普通无约束最小二乘的精确预测,在等价的可逆特征缩放下可以保持不变;但缩放会影响梯度优化的条件,加入正则化后也会影响惩罚的相对作用。因此,是否缩放应结合求解方式和模型设置判断。
还要避免因果误读:权重描述模型在所选特征和数据条件下的关联,不证明改变某个输入就一定导致相应的现实结果。遗漏变量、选择偏差与数据分布变化,都可能影响解释和预测。
7. 小结
线性回归把监督学习拆成了可检查的环节:特征作为输入,标签提供目标,模型规定函数形式,损失衡量误差,训练确定参数,独立评估检验使用价值。
下一篇将把连续数值预测改为二分类,解释逻辑回归为何输出概率,以及分类阈值如何影响结果。更多推导可参考 Dive into Deep Learning:Linear Regression。