从零开始学习大模型(六):逻辑回归,如何从数值预测转向分类?
线性回归预测连续数值。对于邮件是否为垃圾邮件、一次操作是否异常等问题,目标通常是离散类别。二分类中可以用 y = 1 表示正类、y = 0 表示负类,但正负类如何定义,必须由任务明确。
逻辑回归(Logistic Regression)虽然名称包含“回归”,却常用于分类。它先计算线性分数,再将分数映射为正类概率,最后根据决策规则给出类别。
1. 为什么不能直接把线性输出当成概率
线性模型的输出 z = w · x + b 可以小于 0,也可以大于 1,不满足概率的范围约束。二分类逻辑回归使用 Sigmoid 函数进行映射:
p = sigmoid(z) = 1 / (1 + exp(−z))
这里的 p 建模为给定输入 x 时属于正类的条件概率。对于有限实数分数,其值位于 0 与 1 之间;z = 0 时,p = 0.5。
| 线性分数 z | 正类概率 p(约) | 含义 |
|---|---|---|
| −2 | 0.1192 | 对正类支持较低 |
| 0 | 0.5000 | 两类概率相同 |
| 1 | 0.7311 | 对正类支持较高 |
| 2 | 0.8808 | 比分数 1 更倾向正类 |
概率只是模型输出,不是事实正确性的保证。若样本与训练分布不同,或模型假设不适用,输出可能明显偏离真实发生频率。
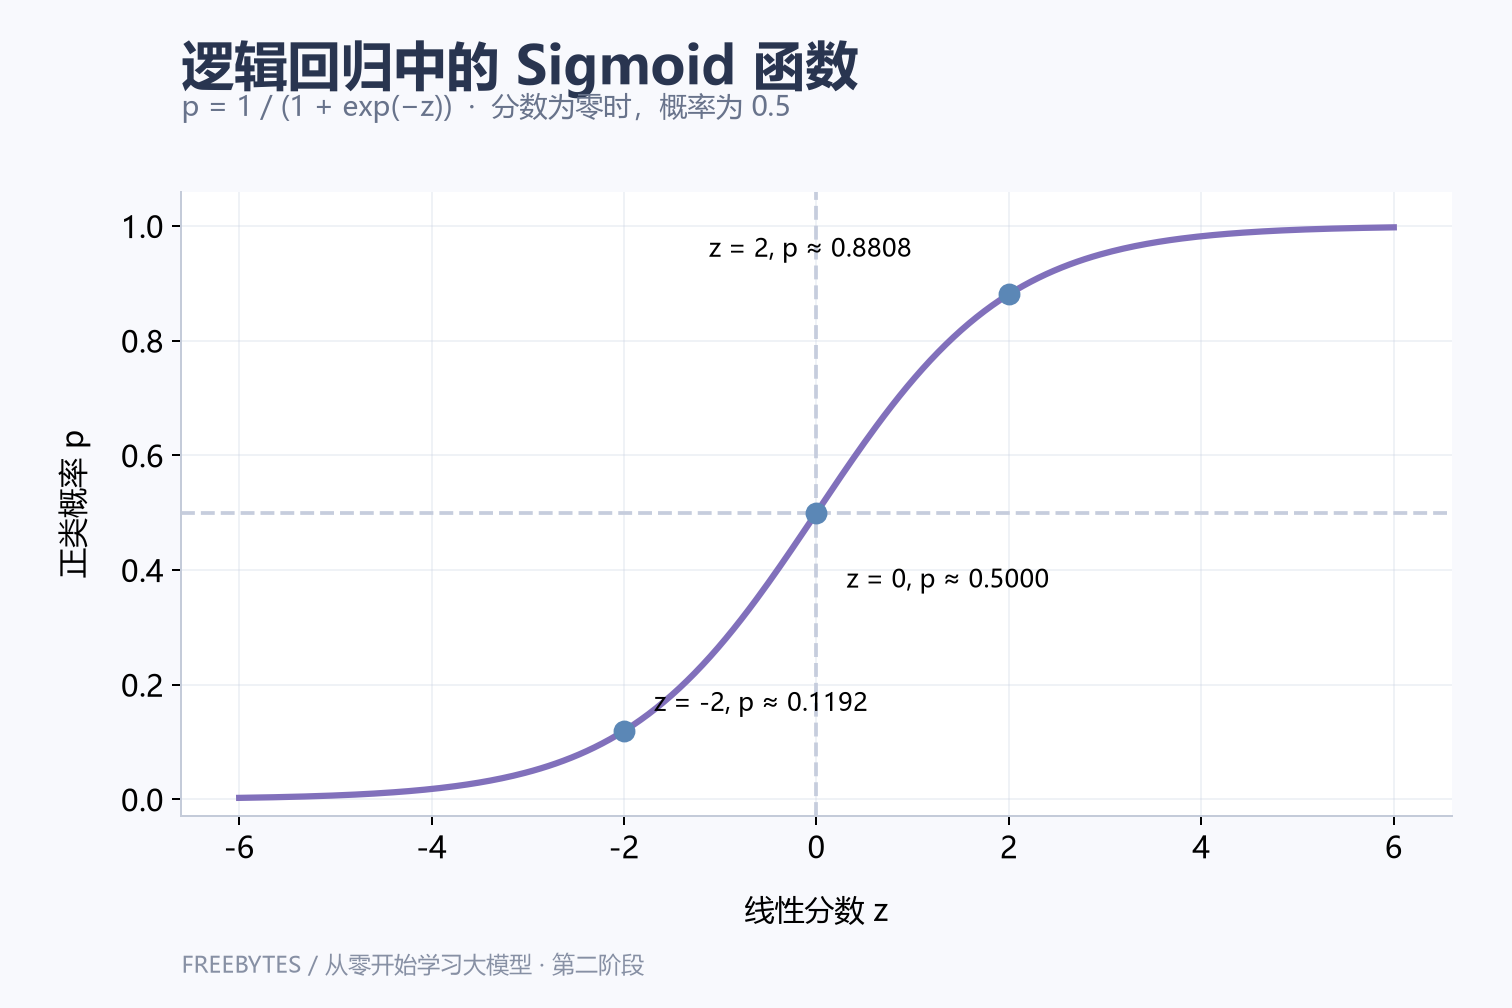
图 1:Sigmoid 的实际函数曲线。横轴是线性分数,不是原始类别,也不是整个系统的可信度。
2. 逻辑回归的线性假设在哪里
将概率变换为几率,再取对数,可得:
odds = p / (1 − p)
ln(odds) = w · x + b
因此,逻辑回归假设正类的对数几率与所选特征线性相关。它并不假设概率本身随输入线性变化。
当一个特征增加 1、其他特征不变时,其对应系数为 w_j,几率会乘以 exp(w_j)。这不是概率增加 w_j,也不直接构成因果解释。涉及相关特征或正则化时,系数解释还需要结合建模设置。
在默认阈值 0.5 下,分类边界满足 w · x + b = 0。对原始特征使用普通线性分数时,这是线性边界;如果引入平方项、交互项等变换,在原始输入空间中可以形成更复杂的边界。
3. 交叉熵如何训练分类模型
二分类的单样本负对数似然,也称二元交叉熵,为:
L = −[y ln(p) + (1 − y) ln(1 − p)]
当 y = 1 时,损失为 −ln(p);当 y = 0 时,损失为 −ln(1 − p)。对错误类别过于集中的预测会受到较大惩罚。
例如,目标为正类时,预测概率 0.9 的损失约为 0.1054,而预测概率 0.1 的损失约为 2.3026。这与第四篇的交叉熵示例一致。
结合 Sigmoid,损失对线性分数的导数可简化为 dL/dz = p − y,继而得到 ∂L/∂w = (p − y)x。求导对象是模型参数,而不是离散的阈值分类结果。实际训练一般直接使用 logits 对应的稳定损失实现,避免指数溢出或对零取对数。
训练时优化概率损失,预测时应用分类阈值,二者应分别处理。阈值不是通过反复查看测试标签来选择的。
4. 同一个模型,不同阈值产生不同分类
考虑固定的教学模型 z = 2x − 3。输入 x = 2 时,z = 1,正类概率约为 0.7311。
- 阈值设为 0.5,按
p ≥ 阈值预测正类。 - 阈值设为 0.8,同一个样本预测为负类。
模型参数和概率没有改变,改变的是决策规则。在一维例子中,阈值 0.5 对应 x = 1.5;阈值 0.8 对应 x ≈ 2.1931。
| 决策设置 | 常见影响 | 选择依据 |
|---|---|---|
| 降低正类阈值 | 正类预测增多,召回率通常不降 | 允许多少误报,漏报代价多大 |
| 提高正类阈值 | 正类预测减少,假阳性率通常不升 | 审核容量、误报约束等 |
| 使用类别权重训练 | 改变训练目标及拟合结果 | 类别与错误成本设置 |
| 保持默认 0.5 | 便于建立初始基线 | 不代表适合所有业务目标 |
阈值提高并不保证精确率在每个有限数据集上都严格增加。训练权重与阈值调整也不是完全等价的操作,前者可能改变模型本身的排序和概率。
5. 用 Python 验证概率、阈值与损失
下面的模型参数是预先指定的教学值,代码只展示推理和损失计算,不宣称执行了模型训练。
from math import exp, log1p, isclose

def sigmoid(z):
    if z >= 0:
        return 1.0 / (1.0 + exp(-z))
    e = exp(z)
    return e / (1.0 + e)

def binary_loss(z, y):
    return max(z, 0.0) - z * y + log1p(exp(-abs(z)))

x = 2.0
z = 2.0 * x - 3.0
p = sigmoid(z)
assert isclose(p, 0.7310585786, rel_tol=1e-9)
assert int(p >= 0.5) == 1
assert int(p >= 0.8) == 0
assert isclose(binary_loss(z, 1), 0.3132616875, rel_tol=1e-9)
print(round(p, 4), round(binary_loss(z, 1), 4))
分段计算 Sigmoid,能够避免对非常大的正数直接做指数运算;损失使用稳定的 logits 公式。极端输入仍受浮点表示精度限制,不能据此认为数值计算无限精确。
6. 准确率与概率校准不是同一问题
两个模型可能给出完全相同的类别,却为这些类别分配不同概率。分类准确率只检查类别是否正确,不能完整评价概率质量。
如果某模型在大量预测概率接近 0.8 的样本上,正类实际发生比例也接近 0.8,可以认为该区间具有较好的校准表现。这需要足量、相关的数据验证,不是观察某一个预测就能判断的。
实际评估应同时考虑类别不平衡、阈值下的混淆矩阵、概率损失与校准。必要的校准操作应使用独立的适当数据,不应继续利用最终测试集调节模型。
逻辑回归常作为表格分类任务的基线。它便于训练与分析,但仍依赖特征处理和合适的数据;遇到复杂交互关系时,可以考虑特征变换或其他模型,而不是直接把更大参数规模等同于更好结果。
7. 小结
逻辑回归由线性分数、Sigmoid 概率映射和分类决策三部分组成。交叉熵用于训练概率模型,阈值用于根据业务目标做决策,概率校准则检验输出与实际频率是否一致。
下一篇将介绍另一类建模方式:通过特征条件划分数据的决策树,以及如何通过集成得到随机森林。可进一步参考 scikit-learn:Logistic Regression。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
上一篇:线性回归,机器学习到底在学什么?