从零开始学习大模型(八):过拟合与模型评估,准确率高就够了吗?
模型在已有样本上预测准确,不等于在新数据上有效。机器学习真正需要关注的是泛化:在明确的数据分布和使用条件下,模型对未参与训练的样本能达到什么表现。
评估不是训练结束后附加的一次打分。从任务定义、样本划分到阈值选择,每一步都可能影响结果。本篇将线性模型和树模型放到统一的评估框架中,并完成第二阶段的知识闭环。
1. 训练集、验证集与测试集分别做什么
训练集用于估计参数,例如线性回归的权重或树的划分条件。验证集用于选择模型、特征、超参数和分类阈值。测试集用于最终方案固定后的独立评估。
如果根据测试结果反复更改模型,这部分数据事实上已经参与选择,不能继续作为完全独立的最终测试。反复使用同一个验证集也可能导致选择偏差,尤其是在尝试大量方案时。
划分方式应接近实际使用条件:
- 独立同分布的样本,可以考虑随机划分,必要时按类别分层。
- 预测未来数据,应考虑时间顺序,避免用未来信息预测过去。
- 同一用户、设备或文档产生多条记录,应考虑分组划分。
- 存在近重复样本时,应先设计去重与分组策略,避免内容跨集合重复。
交叉验证可以在数据较少时更充分地利用训练部分的数据,但预处理也必须在每个训练折内部拟合。若同时需要无偏地评估大量超参数选择,可以考虑嵌套交叉验证或保留独立测试集。
2. 欠拟合与过拟合
模型表达能力不足、特征不合适或优化不充分时,可能连训练数据都无法较好拟合,这常与欠拟合有关。
模型在训练数据上表现很好,但在适当的验证数据上明显变差,则可能存在过拟合:拟合了训练集中的噪声或偶然模式,而不只是在学习可推广的规律。
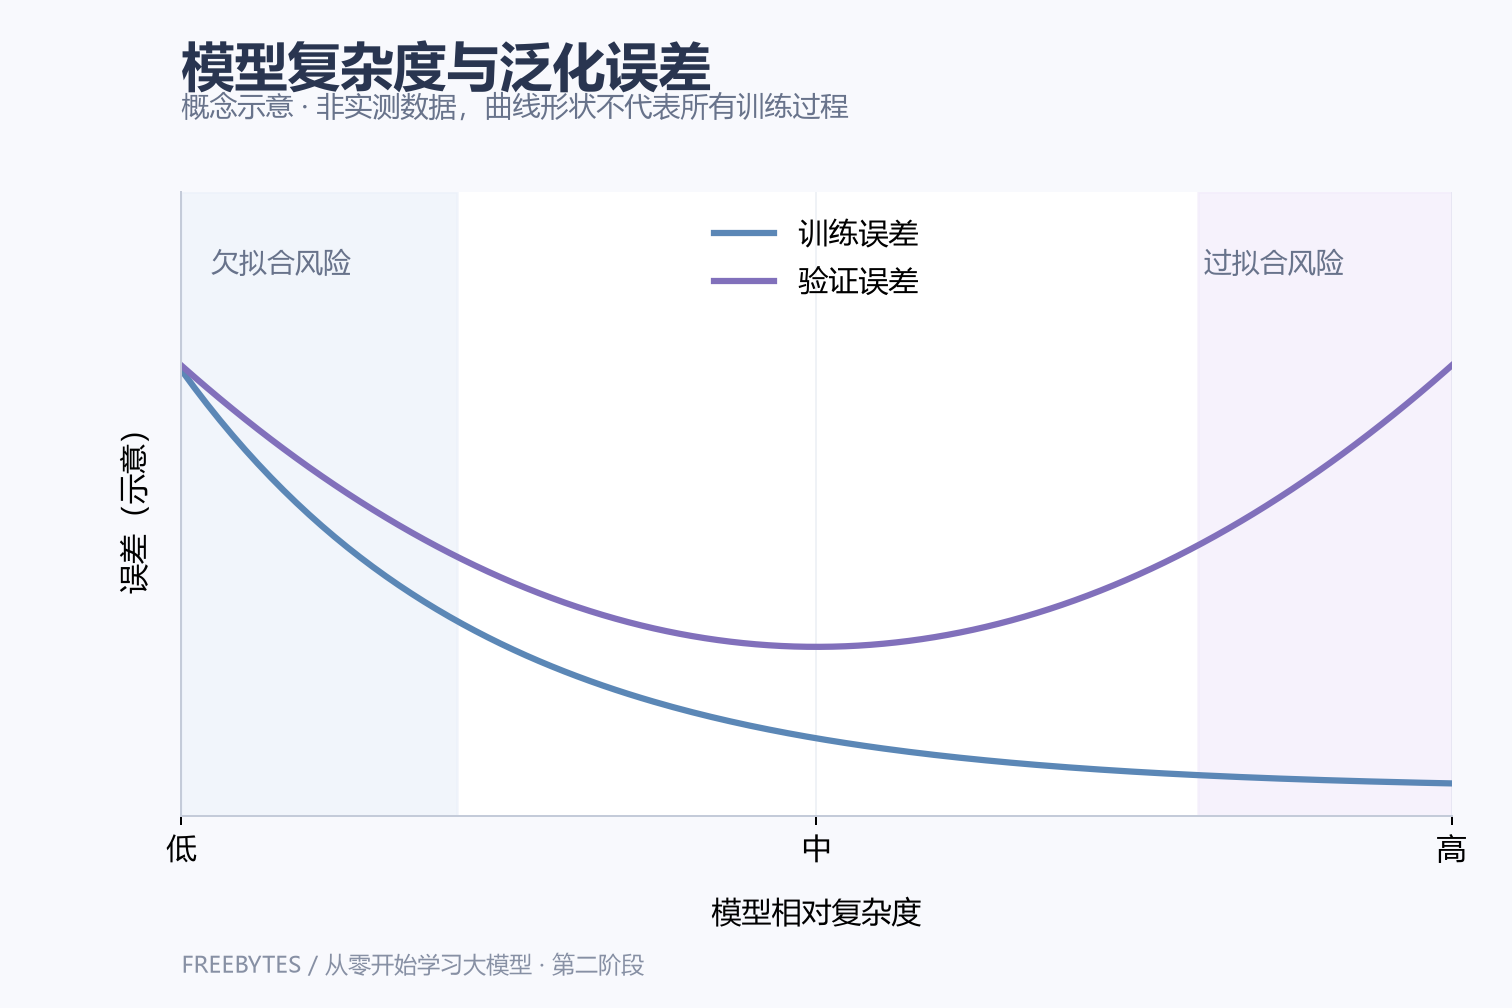
图 1:解释欠拟合与过拟合的概念示意,不是实测结果。真实曲线不一定平滑、单调或呈标准 U 形,需要结合具体实验分析。
训练与验证之间存在差距,也可能来自分布变化、标签质量或采样方式,不应在未排查原因时全部归结为模型过于复杂。
3. 正则化如何约束模型
正则化通过限制模型或训练过程,改变复杂度与拟合之间的取舍。例如 L2 正则化常写为:
总目标 = 训练数据损失 + λ × Σⱼ wⱼ²
λ 控制惩罚强度,具体归一化系数与是否惩罚偏置取决于实现。惩罚过强也可能造成欠拟合。L1 惩罚使用权重绝对值之和,在某些设置下可以产生稀疏解。
对树模型,可通过限制深度、增大叶节点最少样本数或剪枝控制复杂度。对迭代训练,可使用早停:根据验证表现选择停止点,而不是只选择训练损失最低的轮次。
更多相关训练数据、合理的数据增强和更符合任务的特征,也可能改善泛化;它们都需要验证,不存在适用于所有任务的固定组合。
4. 一张混淆矩阵能说明什么
假设测试集中有 1000 个样本,其中正类 10 个、负类 990 个。某个分类器在选定阈值下的结果如下:
| 实际类别 | 预测为正 | 预测为负 | 合计 |
|---|---|---|---|
| 正类 | 8(TP) | 2(FN) | 10 |
| 负类 | 18(FP) | 972(TN) | 990 |
| 合计 | 26 | 974 | 1000 |
TP 是正确识别的正类,FN 是漏掉的正类,FP 是误判为正类的负类,TN 是正确识别的负类。矩阵中哪一轴表示实际类别,应在展示时明确,不能只展示四个没有标签的数字。
据此可以计算:
Accuracy  = (TP + TN) / N = 980 / 1000 = 98%
Precision = TP / (TP + FP) = 8 / 26 ≈ 30.77%
Recall    = TP / (TP + FN) = 8 / 10 = 80%
F1        = 2TP / (2TP + FP + FN) = 16 / 36 ≈ 44.44%
如果始终预测负类,准确率反而达到 99%,但正类召回率为 0。这说明在类别高度不平衡时,准确率单独使用可能掩盖重要问题。
上述模型虽然准确率更低,却找到了 8 个正类,是否值得使用还取决于 18 次误报的成本、漏报代价和处理能力。不能仅凭某个指标较高就给出业务结论。
5. 如何选择评价指标
| 关心的问题 | 可考虑的指标 | 解释边界 |
|---|---|---|
| 正类是否被遗漏 | Recall、漏报数量 | 需同时观察误报代价 |
| 告警是否可靠 | Precision、误报数量 | 受阈值和基础发生率影响 |
| 精确率与召回率的折中 | F1、PR 曲线 | F1 不体现所有成本,也忽略 TN |
| 概率排序能力 | ROC-AUC、PR 相关指标 | 不等于某个阈值下的业务收益 |
| 概率估计质量 | 对数损失、Brier 分数及校准分析 | 与类别预测准确率不同 |
| 连续预测偏差 | MAE、RMSE、残差分布 | 结合单位及不同区间分析 |
ROC-AUC 反映跨阈值的排序表现,不能替代实际阈值下的精确率。正类很少时,PR 曲线通常值得重点观察,但 PR-AUC 的数值也依赖基础发生率;不同积分或汇总约定不宜混用。
Precision 和 Recall 的分母可能为零,评估工具需要指定此时的处理策略。本文示例的分母均非零,不能直接将示例代码作为所有数据情形的通用实现。
6. 用 Python 核对指标
以下代码只使用 Python 标准库,直接由混淆矩阵计算四个指标,并与始终预测负类的基线比较。
from math import isclose

tp, fn, fp, tn = 8, 2, 18, 972
total = tp + fn + fp + tn
accuracy = (tp + tn) / total
precision = tp / (tp + fp)
recall = tp / (tp + fn)
f1 = 2 * tp / (2 * tp + fp + fn)
baseline_accuracy = (fp + tn) / total

assert isclose(accuracy, 0.98)
assert isclose(precision, 4 / 13)
assert isclose(recall, 0.8)
assert isclose(f1, 4 / 9)
assert isclose(baseline_accuracy, 0.99)
print(*(round(x, 4) for x in [accuracy, precision, recall, f1]))
输出约为 0.98 0.3077 0.8 0.4444。这里展示的是人工设定的完整混淆矩阵,不是某个真实产品或数据集的测评。
7. 比过拟合更隐蔽的问题:数据泄漏
常见泄漏包括:先用全量数据拟合标准化或缺失值填补规则,再划分测试集;让同一人的记录进入不同集合;使用预测时点之后产生的字段;依据测试结果反复选择特征和阈值。
正确做法是把数据划分放在适当位置,在每个训练折内拟合预处理与特征选择,并保证验证和测试只执行已确定的变换。目标编码等依赖标签的处理,通常还需要更谨慎的折内设计。
即使没有泄漏,线上数据分布也可能变化。上线后应持续监测输入、标签可获得性、群体表现和业务结果,必要时重新训练,并保留模型与数据处理版本。
8. 第二阶段小结
一个可复查的评估流程应当明确任务、预测时点、数据来源、划分规则、基线、选择依据和最终测试结果。报告除了平均指标,还应说明样本量、类别分布和关键群体的表现;有需要时报告不确定性,而不是把单次小样本结果视为确定结论。
至此,第二阶段完成了从线性回归、逻辑回归、树模型到泛化评估的完整流程。后续进入神经网络时,模型结构会更复杂,但特征、目标、损失、训练与独立评估这些基本环节仍然适用。
第三阶段从神经网络中的线性层与激活函数开始,再介绍反向传播实践和 CNN。指标定义与实现细节可参考 scikit-learn:Model Evaluation。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
下一篇:神经网络为什么需要非线性?