从零开始学习大模型(七):决策树与随机森林,模型如何划分数据?
前两篇用线性函数描述预测关系。决策树采用不同方式:依次检查特征条件,将样本分到不同区域,再由所在叶节点给出预测。
这使树能够表达分段规则与特征交互,而不要求所有输入共同服从一条直线。但规则由数据和训练算法选择,并不意味着自动得到的划分就是稳定、正确或具有因果意义的业务规律。
1. 决策树由哪些部分组成
一棵典型的二叉决策树包含内部节点、分支和叶节点。内部节点检查条件,例如 x ≤ 3.5;分支表示条件结果;叶节点保存用于预测的信息。
分类树通常根据叶节点中的类别统计给出类别或概率估计;普通平方误差回归树通常用叶节点训练标签的均值作为预测。具体规则取决于任务与实现。
以下使用六个合成样本:输入依次为 [1, 2, 3, 4, 5, 6],类别依次为 [0, 0, 0, 1, 1, 1]。
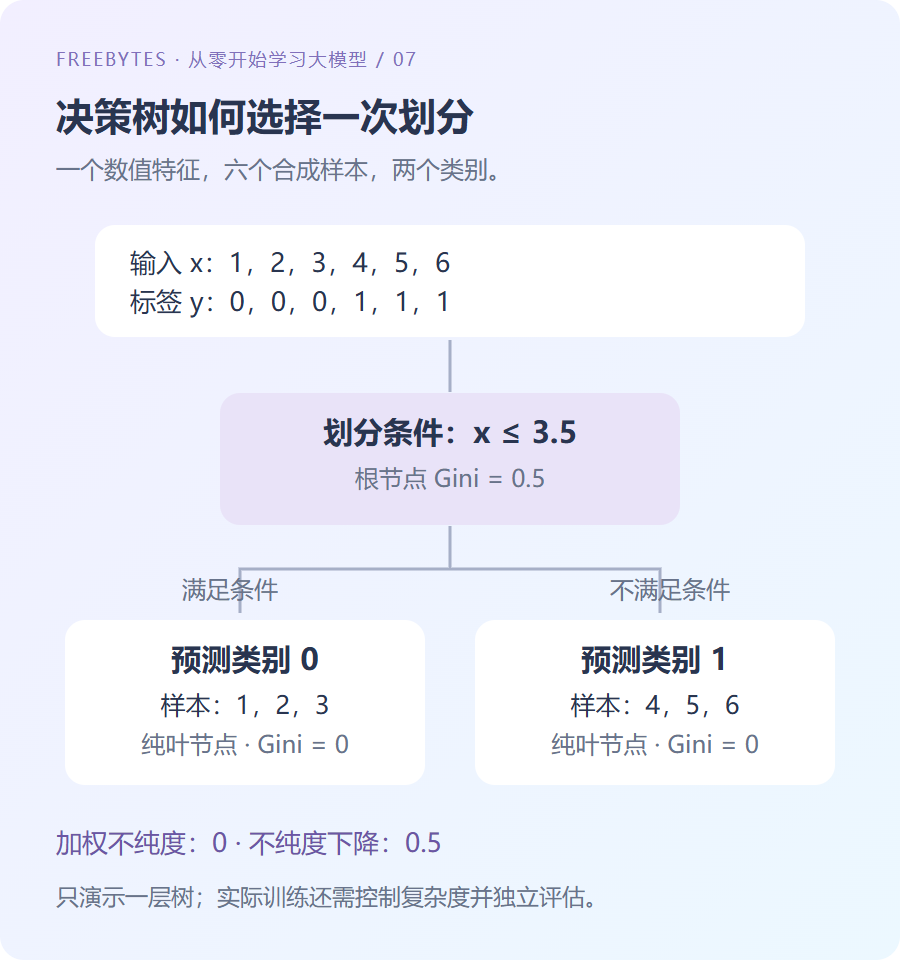
图 1:根据本文六个样本得到的最优单次划分。它只演示一个特征与一层树,不代表复杂任务通常能够被单个条件解决。
2. 如何衡量一次划分是否有效
分类任务可以用基尼不纯度(Gini Impurity)衡量节点中类别的混合程度:
Gini = 1 − Σₖ pₖ²
pₖ 表示节点中第 k 类样本的比例。纯节点的不纯度为 0;二分类中,两类各占一半时为 0.5。本例根节点包含三个负类、三个正类,因此不纯度为 0.5。
划分后,需要按左右子节点的样本数量加权:
划分后不纯度 = (n_left/n) × Gini_left
             + (n_right/n) × Gini_right
不纯度下降 = 划分前不纯度 − 划分后不纯度
| 候选条件 | 加权后的不纯度 | 不纯度下降 |
|---|---|---|
| x ≤ 1.5 | 0.40 | 0.10 |
| x ≤ 2.5 | 0.25 | 0.25 |
| x ≤ 3.5 | 0.00 | 0.50 |
在这些候选条件中,3.5 的划分使两侧都成为纯节点,因此下降最多。选择阈值后,算法还可以对子节点继续寻找划分,直到满足停止条件。
另一种常见指标是类别熵,其下降通常称为信息增益。基尼不纯度下降与基于熵的信息增益相关,但公式不同;不要将它们的具体数值混用。回归树则常通过降低平方误差等准则选择划分。
多数常见树算法使用局部贪心选择:每一步优先选择当前效果较好的划分,不保证得到所有可能树结构中的全局最优结果。
3. 可运行示例:实际搜索最佳阈值
下面仅使用 Python 标准库,枚举相邻输入值的中点。样本只有一个数值特征,代码只训练深度为一的分类树,也称决策树桩。
from collections import Counter
from math import isclose

samples = [(1, 0), (2, 0), (3, 0), (4, 1), (5, 1), (6, 1)]

def gini(labels):
    counts = Counter(labels)
    return 1 - sum((n / len(labels)) ** 2 for n in counts.values())

def split_impurity(threshold):
    left = [y for x, y in samples if x <= threshold]
    right = [y for x, y in samples if x > threshold]
    return (len(left) * gini(left) + len(right) * gini(right)) / len(samples)

values = sorted({x for x, _ in samples})
candidates = [(a + b) / 2 for a, b in zip(values, values[1:])]
best = min(candidates, key=split_impurity)
assert best == 3.5
assert isclose(split_impurity(best), 0.0)
assert isclose(split_impurity(2.5), 0.25)
print(best, split_impurity(best))
候选阈值保证两侧非空,因此这里的 gini 不处理空列表。实际实现还需要考虑样本权重、缺失值、多个特征与复杂度约束。
4. 为什么需要限制树的复杂度
持续分裂可以让叶节点越来越小,甚至只包含一个训练样本。此时训练误差可能很低,但规则可能主要反映噪声或偶然差异。
常见限制包括最大深度、叶节点最少样本数、最小不纯度下降,以及训练后进行剪枝。树越深不一定越好,应通过合适的验证数据选择复杂度。
单棵深树还可能对数据变化敏感:少量样本改变就可能导致上层划分变化,进而改变整棵树。集成方法的重要动机之一,就是通过多个模型组合改善稳定性。
5. 随机森林如何组合多棵树
随机森林(Random Forest)通常为不同树抽取不同的训练样本,并在节点划分时只考虑随机选择的部分特征。常见的有放回抽样称为 bootstrap:某个样本可能重复出现,也可能没有被抽到。
这些随机性用于降低树之间的相关性。多棵结果高度相同的树,组合收益通常有限。回归森林常对树的预测求平均;分类森林可以聚合类别概率后选择类别,具体实现应以库文档为准,不能一概等同于硬投票。
森林通常能降低单棵树的方差,但不保证在每项任务上优于所有其他方法。增加树数也会增加训练、存储与推理成本。
未参与某棵树 bootstrap 训练的样本称为该树的袋外样本,可用于袋外(OOB)评估。对于时间序列、同一用户多条记录等数据,普通袋外评估未必满足真实独立性要求,不能替代恰当的时间或分组划分。
6. 随机森林与梯度提升树有什么区别
| 方法 | 核心方式 | 常见特点与限制 |
|---|---|---|
| 单棵决策树 | 逐层划分数据空间 | 小树较易理解,深树可能不稳定 |
| 随机森林 | 训练多棵带随机性的树并聚合 | 常用于降低方差,单棵树间较易并行 |
| 梯度提升树 | 逐轮加入模型以优化整体损失 | 关注后续轮次的改进,需控制迭代数和学习率 |
梯度提升并不是简单地将多棵独立树平均。后续模型根据当前整体模型的损失信息训练;平方误差情况下可以理解为拟合残差,其他损失一般需要使用相应的梯度信息。
这类模型在表格数据任务中经常值得作为候选,但其效果需要在具体数据和预算下比较,不能仅凭模型名称判断。
7. 使用树模型时的解释边界
基于阈值的普通树划分,对数值特征的严格单调变换通常较不敏感,因此一般不像带距离度量或正则化的线性模型那样依赖标准化。不过,缺失值、类别特征与数值精度的处理依赖具体实现。
特征重要性也有局限。基于训练不纯度下降的分数可能偏向可选择切分较多的特征;相关特征还可能分摊重要性。验证集上的置换重要性可提供另一种分析视角,但同样受到特征相关性等条件影响。
重要性高不等于因果影响大。对于普通叶均值回归树和相应森林,预测来自叶节点中的训练标签统计,也不应期待其像线性函数那样自然外推趋势。
8. 小结
决策树通过划分条件组织预测,训练目标是降低所选准则下的不纯度或误差。限制复杂度用于改善泛化,随机森林与梯度提升则以不同方式组合多棵树。
下一篇将集中讨论如何公平评估这些模型,包括过拟合、数据泄漏、混淆矩阵与指标选择。更多细节可参考 scikit-learn:Decision Trees。