从零开始学习大模型(二十一):Token、预训练与 Scaling Law
大规模预训练将网络结构、语料和优化过程组合起来。模型从大量文本中获得可用于后续任务的参数,但过程并不是把整个互联网原样装进一个可精确查询的数据库。
本篇以常见的稠密、自回归文本模型为主,不把所有多模态或专家混合模型都套用到同一计算假设中。
1. 从文本到训练位置
分词器定义文本如何变为 Token 编号。字符、子词和字节级方法有不同覆盖与压缩特点,词表及特殊符号也属于模型配置的一部分。
输入编号经 Embedding 变为向量,经过模型得到每个位置的词表 logits,再对实际目标 Token 计算交叉熵。训练信号来自文本自身的后续内容,因此通常归为自监督学习。
| 步骤 | 目标 | 需要检查 |
|---|---|---|
| 收集与筛选 | 获得适合任务的语料 | 来源许可、隐私与数据质量 |
| 去重与划分 | 降低重复及评估污染 | 近重复、文档边界、测试来源 |
| 分词与打包 | 构造有限长度的训练输入 | 特殊符号、截断与掩码 |
| 优化与验证 | 调整参数并监控泛化 | 损失、稳定性与独立评估 |
训练数据中的错误、偏差和重复可能影响参数,更多数据并不自动等于更高质量。
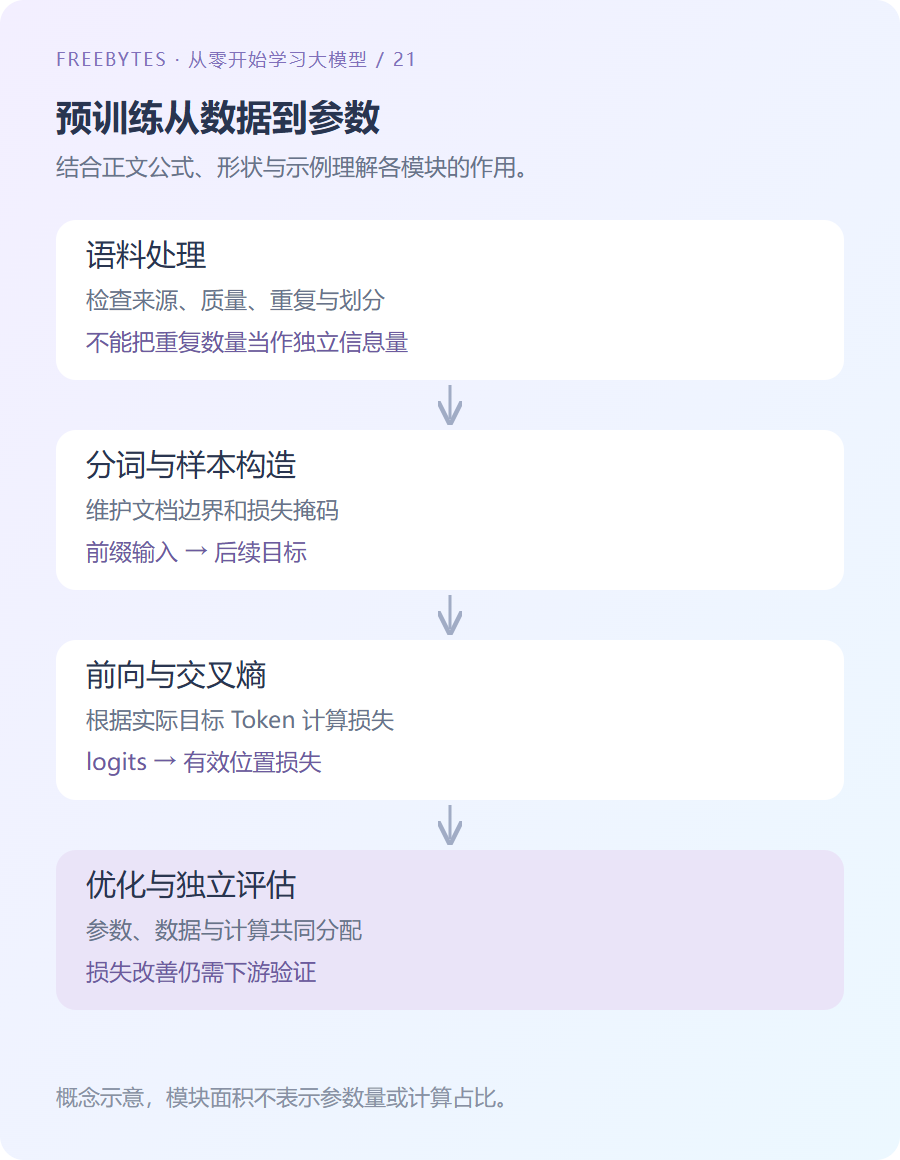
图 1:预训练的主要环节,省略分布式通信与检查点管理。
2. 数据打包与损失掩码
长文本可切成固定窗口,短文本可按规则拼接。是否允许跨文档注意力、是否加入分隔符,以及哪些位置计入损失,都会影响训练任务。
填充位置通常不应计入平均损失。对话后训练可能只计算回答部分,预训练则采用不同规则。打包不是简单把字符串拼在一起,还需要维护语义边界与有效位置。
下面使用字符级词表演示编码与标签移位,它不是 BPE,也不是一个实际预训练实验。
text = '模型学习模型'
vocabulary = sorted(set(text))
indices = {char: i for i, char in enumerate(vocabulary)}
tokens = [indices[char] for char in text]
inputs, targets = tokens[:-1], tokens[1:]
assert len(vocabulary) == 4
assert len(inputs) == len(targets) == 5
assert ''.join(vocabulary[i] for i in tokens) == text
parameters, training_tokens = 10**9, 20 * 10**9
estimated_flops = 6 * parameters * training_tokens
assert estimated_flops == 12 * 10**19
print(len(vocabulary), len(inputs), estimated_flops)
3. 参数、数据与计算预算如何联系
对部分稠密 Transformer 训练设置,常用 C ≈ 6ND 粗略估计主要训练计算量,其中 N 为参数量、D 为训练 Token 数。它不是显存公式,也不直接给出实际耗时。
注意力长度项、重计算、嵌入层处理、硬件效率和通信都可能改变实际开销。专家混合模型还需要区分总参数与激活参数,不能不加说明地套用同一个 N。
| 量 | 描述什么 | 不能单独说明什么 |
|---|---|---|
| 参数量 | 模型容量与权重存储规模 | 实际任务质量 |
| 训练 Token 数 | 优化过程中处理的文本单位数量 | 独立高质量信息量 |
| FLOPs | 运算量估计 | 硬件吞吐与端到端时间 |
| 训练损失 | 所选目标的拟合表现 | 所有下游能力与安全性 |
4. Scaling Law 应如何理解
规模规律描述在一定模型、数据和训练范围内,损失与参数、数据或计算之间的经验关系。它能帮助分配预算,但不是无限外推的普遍定律。
计算最优的模型大小与训练数据量需要共同考虑。较大模型如果训练不足,可能不如较小但训练更充分的模型;若目标包含多次推理成本,最优选择又可能变化。
此外,分词器、数据分布和评估规则不同的损失不能直接比较。局部损失改善也不等于特定能力必然按同一速度提升。
5. 为什么必须控制评估污染
如果测试题或近重复内容进入训练,模型可能利用记忆而非可推广的能力。需要在文档和样本层面检查重复,并结合时间切分、保留集与独立任务分析。
语料中存在某个事实,也不保证模型能稳定复述;不存在某条最新知识时,也不应期待仅靠参数生成得到可靠更新。外部检索与工具会在后续应用篇讨论。
下一篇介绍从预训练模型到指令助手的后训练过程。计算与规模分配的原始研究见 Training Compute-Optimal Large Language Models。