从零开始学习大模型(二十三):KV Cache、量化与 LoRA 解决什么问题?
大模型的成本不仅来自参数数量。序列长度、并发请求、数值精度、缓存策略与硬件内核都会影响内存和延迟。量化、KV Cache 与 LoRA 面向不同环节,不能视为三个等价的“压缩模型”按钮。
1. Prefill 与 Decode
Prefill 处理已有输入前缀,通常能同时计算多个位置;Decode 则根据已有结果逐步生成新 Token。两阶段的计算形状与瓶颈可能不同。
KV Cache 保存此前位置的 Key 和 Value,减少后续生成时重复计算历史表示的工作。它不意味着每一步完全不再访问历史,也不是把全部历史注意力输出原样缓存。
| 组成 | 与什么有关 | 常见误解 |
|---|---|---|
| 模型权重 | 参数量与存储精度 | 能装下权重就一定能运行 |
| KV Cache | 层数、长度、键值头、批次与精度 | 与上下文长度无关 |
| 激活与工作区 | 算法、批量与内核 | 总能忽略不计 |
| 训练状态 | 梯度、优化器与精度策略 | 等于推理权重大小 |
2. 估算一份 KV Cache
对常见解码器设置,可近似写为 bytes = 2 × L × B × T × H_kv × d_head × bytes_per_element。2 表示 K 与 V,L 为层数,B 为批次,T 为缓存长度。
例如 L=12、B=1、T=2048、H_kv=4、d_head=64,每元素 2 字节,得到 24 MiB。这里 MiB 是 2²⁰ 字节,不是十进制 MB。
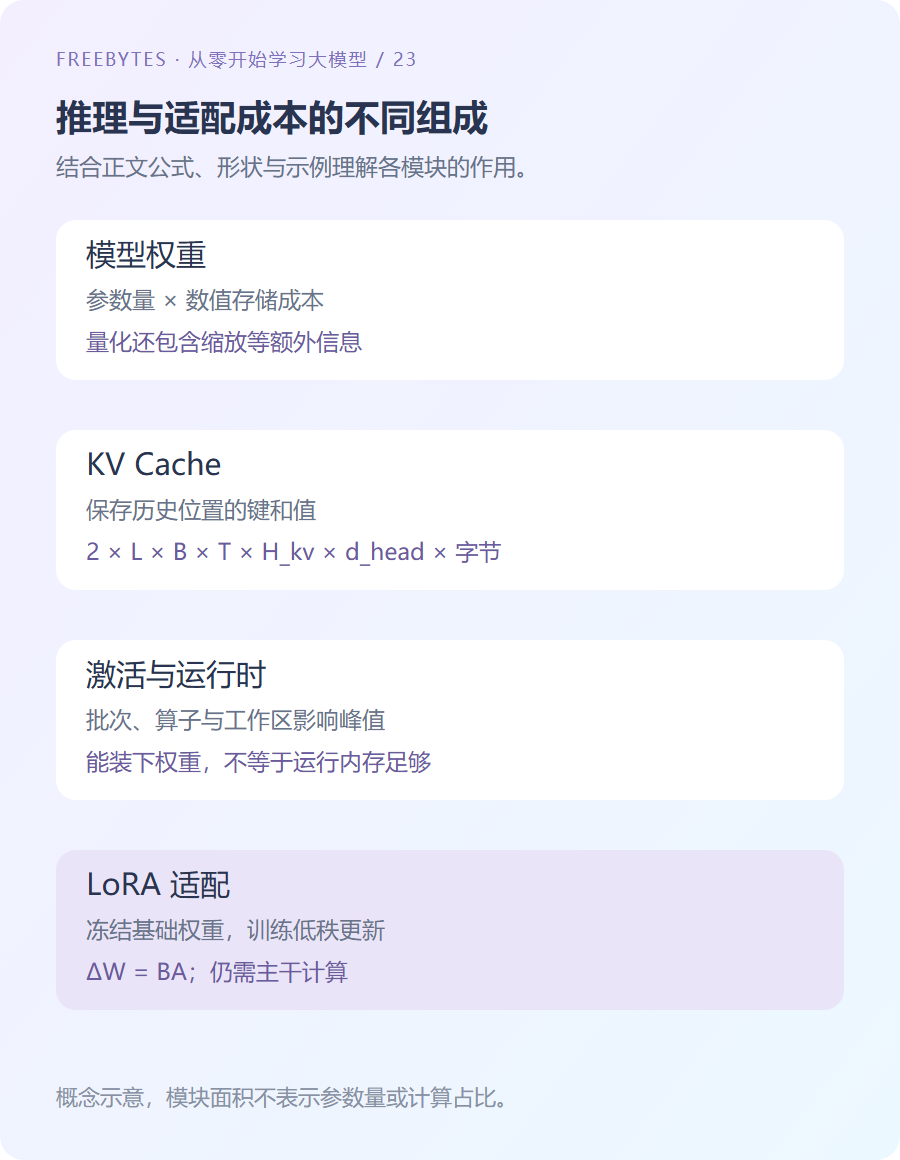
图 1:不同资源组成的概念关系,图中模块面积不表示实际占比。
该估算不包含缓存元数据、分配碎片、不同请求长度和实现特有开销。GQA/MQA 会改变键值头数,应使用 H_kv 而不是直接代入查询头数。
3. 量化改变数值表示
量化用较低位宽表示权重或部分激活。理想的位数估算只能作为下界式粗算,实际还可能存储缩放因子、零点、分组信息和其他精度的参数。
量化可能减少内存与带宽需求,但速度取决于硬件和内核支持,也可能影响质量。不能将“4 bit”直接解释为所有运行内存都下降到原来的四分之一。
4. LoRA 改变可训练更新的表示
对于形状为 (d_out,d_in) 的权重 W,LoRA 可将更新表示为 ΔW = BA,A 形状为 (r,d_in)、B 为 (d_out,r)。基础权重通常冻结,只训练较小矩阵,并按设置使用缩放。
| 方法 | 主要作用 | 不自动解决的问题 |
|---|---|---|
| KV Cache | 复用历史键值 | 长上下文缓存增长 |
| 量化 | 降低部分数值存储或计算精度 | 所有工作区与质量问题 |
| LoRA | 降低适配时的可训练参数量 | 冻结主干的前向计算和全部激活 |
| 低比特主干配适配器 | 组合量化与参数高效微调 | 无条件保持质量或兼容全部内核 |
LoRA 训练仍可能需要通过主干计算激活与梯度路径,只是不为冻结权重保存同样的可训练状态。能否合并权重及合并后的精度表现,也需结合实现检查。
5. 用代码核对数量级
layers, batch, length = 12, 1, 2048
kv_heads, head_width, element_bytes = 4, 64, 2
cache_bytes = 2 * layers * batch * length * kv_heads * head_width * element_bytes
assert cache_bytes / 2**20 == 24

d_in = d_out = 4096
rank = 8
full_parameters = d_in * d_out
lora_parameters = rank * (d_in + d_out)
assert full_parameters == 16777216
assert lora_parameters == 65536
print(cache_bytes // 2**20, full_parameters // lora_parameters)
本例单个矩阵的更新参数量减少 256 倍,不代表整个模型训练显存或时间也减少相同比例。基础权重、其他可训练模块、激活和优化策略都需单独计入。
6. 实际评估应测什么
应记录输入与输出长度、并发、硬件、精度、首 Token 延迟、后续 Token 速度和总吞吐。不同测量条件下的数字不能直接比较,单请求速度也不等于服务整体容量。
同时验证输出质量和长上下文行为,再决定是否接受压缩或速度收益。下一篇将这些模型能力与外部知识检索连接起来。LoRA 的原始研究见 LoRA。