从零开始学习大模型(二十二):SFT、RLHF 与 DPO 分别训练什么?
预训练目标是预测文本,而用户期望模型按指令完成任务、遵循格式并给出有依据的回答。这些目标并不天然一致,后训练因此成为实际助手模型的重要环节。
后训练方法很多,本篇讨论三条常见路线,不意味着所有模型都采用完全相同的训练顺序。
1. SFT 如何使用示范回答
监督微调(SFT)使用指令、上下文和目标回答等样本,常通过目标回答的 Token 负对数概率训练模型。
模板、角色标记、结束符与损失掩码都是训练设置的一部分。如果推理模板与训练格式不一致,可能明显影响表现。
| 数据形式 | 监督信号 | 常见质量问题 |
|---|---|---|
| 指令与示范回答 | 目标回答的 Token | 错误事实、格式混乱 |
| 同一问题的回答排序 | 相对偏好 | 标注标准不一致、位置偏差 |
| 工具交互轨迹 | 调用与结果后的行为 | 权限、错误处理与工具结果可靠性 |
| 多轮对话 | 上下文中的持续任务行为 | 角色边界与隐私泄露 |
高质量示范有助于塑造任务行为,但不保证把所有事实都可靠写入参数。只改变文风也不等于改善推理或事实正确性。
2. 典型 RLHF 流程
一种常见路线先进行 SFT,再通过人类对回答的偏好训练奖励模型,之后使用强化学习方法优化策略,并控制其与参考策略的偏离。
奖励模型是对偏好的近似。若过度优化,模型可能利用奖励函数的漏洞,而不是提高真实质量。因此需要独立评价与约束,不能把奖励分数直接当作客观正确率。
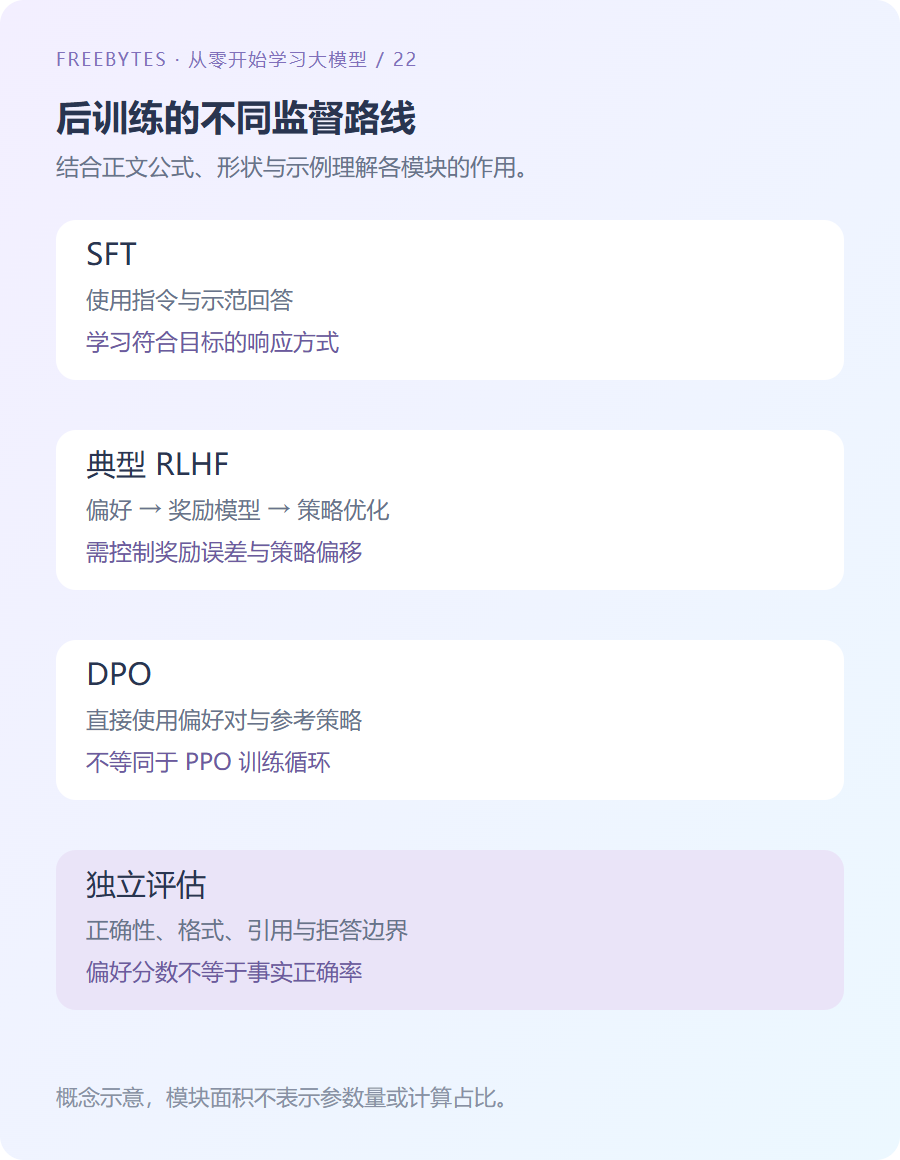
图 1:几种后训练路线的概念关系,不表示所有训练配方必须经过全部节点。
3. DPO 如何直接利用回答对
DPO 使用同一输入下较优回答与较差回答的配对数据,结合策略模型与参考模型的序列对数概率,构造偏好分类目标。典型离线 DPO 不需要按同样方式单独训练奖励模型或执行 PPO 训练循环。
令 Δ = [log πθ(y_w|x) − log πθ(y_l|x)] − [log πref(y_w|x) − log πref(y_l|x)],单样本损失可写为 −log sigmoid(βΔ),β 为超参数。
这里使用序列对数概率,涉及 Token 求和、有效回答位置和长度等条件。不同变体可能改变归约或约束方式,不能把一个标量差公式当成所有偏好算法的通用实现。
4. 核对一个偏好损失
from math import exp, log1p, isclose, log

def dpo_loss(policy_margin, reference_margin, beta):
    score = beta * (policy_margin - reference_margin)
    return max(-score, 0.0) + log1p(exp(-abs(score)))

unchanged = dpo_loss(0.3, 0.3, 0.1)
improved = dpo_loss(1.3, 0.3, 0.1)
assert isclose(unchanged, log(2.0))
assert improved < unchanged
print(round(unchanged, 4), round(improved, 4))
代码仅计算预先给定对数概率差的损失,不包含语言模型、采样或完整训练。损失变小表示符合这条配对监督,不证明回答在客观事实或其他任务上更好。
5. 三条路线如何比较
| 方法 | 主要目标 | 重要边界 |
|---|---|---|
| SFT | 学习示范行为 | 示范质量与覆盖影响很大 |
| 典型 RLHF | 优化奖励所表达的偏好 | 奖励误差、策略偏移与训练稳定性 |
| DPO | 直接拟合相对偏好 | 离线数据覆盖与参考设置重要 |
偏好可能来自人类,也可能包含模型辅助生成或标注。应记录数据来源和标准,不能将所有反馈都称为完全客观的人类结论。
评估应同时观察任务正确性、引用依据、格式、拒答是否适当,以及不同群体与输入条件下的表现。单次自动打分也可能有偏差,需要与人工抽查和可执行验证结合。
下一篇区分推理加速与参数高效微调。相关原始研究:InstructGPT 与 DPO。