从零开始学习大模型(九):神经网络为什么需要非线性?
线性回归与逻辑回归建立了输入、参数和损失之间的联系。神经网络在此基础上,将多个可训练变换组合起来,使模型能够学习更复杂的输入输出关系。
理解网络不能只看层数。真正需要明确的是每层执行什么计算、输出形状如何变化,以及非线性在哪里引入。
1. 一个全连接层如何计算
对按行排列的样本,线性层写为 Z = XW + b。若输入形状为 (B, d),权重为 (d, h),则输出为 (B, h),其中 B 是批次大小。
每个输出位置都组合全部输入特征,因此称为全连接。PyTorch 的 Linear(d, h) 在内部将权重存为 (h, d),相当于计算 XWᵀ + b,阅读代码时应区分存储布局和数学约定。
两层网络可以表示为 H = φ(XW₁ + b₁)、Y = HW₂ + b₂。H 是隐藏表示,φ 是激活函数;输出是否再使用概率映射,取决于任务与损失接口。
| 部分 | 本例形状 | 参数数量 |
|---|---|---|
| 输入 | (B, 3) |
0 |
| 第一层权重与偏置 | (3, 4)、(4,) |
16 |
| 隐藏层输出 | (B, 4) |
0(不额外计入) |
| 第二层权重与偏置 | (4, 2)、(2,) |
10 |
本例共有 26 个可训练参数。激活值不是独立的模型参数,批次大小改变也不会增加这两层的参数数量。
2. 为什么不能只叠加线性层
如果移除激活函数,代入后得到:
Y = (XW₁ + b₁)W₂ + b₂
  = X(W₁W₂) + (b₁W₂ + b₂)
这仍然只是一次仿射变换。无论叠加多少个没有非线性的普通线性层,整体都可以合并为同类变换。多层结构可能改变优化或参数化方式,但不会因此获得一般的非线性表达能力。
3. 激活函数改变了什么
激活函数对中间结果做非线性变换,使后续层能够组合不同输入区域中的响应。
| 函数 | 定义或特点 | 常见限制 |
|---|---|---|
| ReLU | max(0, z) |
负半轴梯度为零,零点不可导 |
| Sigmoid | 输出在 0 与 1 之间 | 大幅度输入可能进入饱和区 |
| tanh | 输出在 −1 与 1 之间 | 同样可能出现梯度较小的饱和区 |
| GELU | 按输入大小平滑调整响应 | 与 ReLU 不同,不会将全部负值置零 |
选择激活函数要结合初始化、网络深度和任务。输出层也不必一律使用 ReLU:回归可能直接输出实数,分类训练可能直接把 logits 交给损失函数。
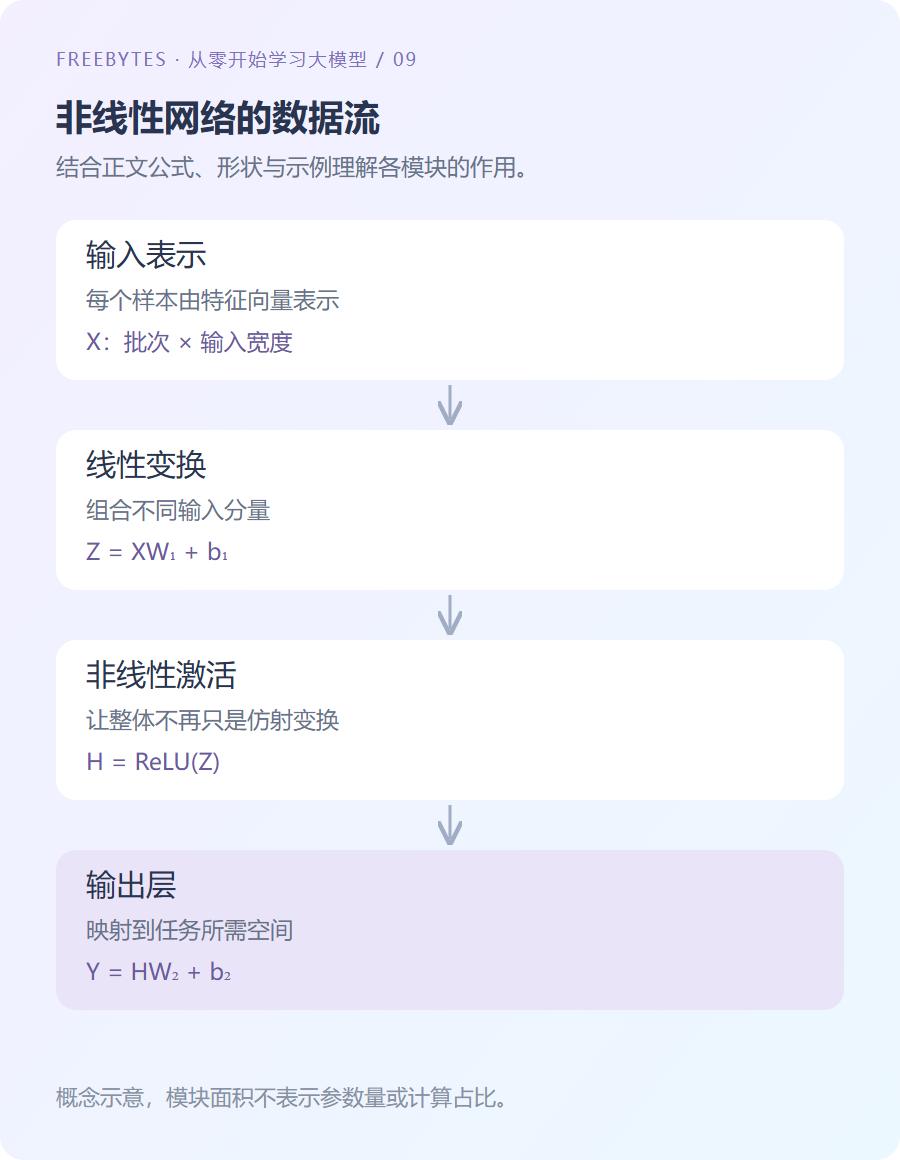
图 1:两层前馈网络的计算结构,省略训练与损失部分。
4. 用 XOR 检查表达能力
XOR 的四个输入是 (0,0)、(0,1)、(1,0)、(1,1),目标依次为 0、1、1、0。在这两个原始特征上,单条直线不能将两类正确分开。
对这些二进制输入,可以构造两个隐藏单元:h₁ = ReLU(x₁ − x₂)、h₂ = ReLU(x₂ − x₁),输出为 h₁ + h₂。
def relu(x):
    return max(0.0, x)

samples = [(0, 0), (0, 1), (1, 0), (1, 1)]
predictions = [relu(a - b) + relu(b - a) for a, b in samples]
assert predictions == [0.0, 1.0, 1.0, 0.0]
print(predictions)
这里的权重是人工指定的,代码证明该结构能够表示这个函数,并不表示已经通过训练学到了权重,也不说明它能自动解决任意任务。
5. 表示能力不等于实际可用性
隐藏层不要求每个单元对应可命名的概念。表示通常由多个单元共同承载,并随训练目标变化,不能仅根据某次激活就赋予其固定语义。
更宽或更深的网络可能扩大函数集合,但也会增加优化、数据和计算需求。训练能否找到有效参数、模型能否泛化,仍需要独立评估。
初始化也很重要。若所有隐藏单元采用完全相同的权重,在对称的训练条件下可能持续学习相同内容。常见初始化根据输入输出规模控制方差,而非简单地把权重全部设为零。
6. 小结
神经网络通过线性变换与非线性激活的组合学习表示。检查网络时,可以先列出每层形状、参数数量与激活位置,再分析损失和训练过程。
下一篇手算一个最小网络的反向传播,说明各参数如何获得梯度。相关概念可进一步参考 Dive into Deep Learning:Multilayer Perceptrons。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
下一篇:手算一个神经网络的反向传播