从零开始学习大模型(十一):用 PyTorch 训练第一个神经网络
掌握前向与反向计算后,就可以使用框架组织训练。本文构建一个两输入、单隐藏层的分类模型,用独立生成的验证数据观察效果,不下载数据集,也不调用外部服务。
示例使用 Python 3.12、PyTorch 2.6.0 的 CPU 环境。可在独立虚拟环境安装 torch==2.6.0;本文使用 CPU wheel,不要求显卡。不同平台的安装方式以官方说明为准。
1. 明确任务和数据
输入是二维坐标,两个分量乘积大于零时标为正类,否则为负类。这形成四个区域,单个线性边界不能正确描述全部区域。
训练集与验证集分别包含 256 和 128 个合成样本,使用固定随机种子生成。标签由明确函数计算,因此样本没有真实业务含义;这个实验只检验训练流程,不证明模型适用于生产任务。
| 对象 | 形状 | 作用 |
|---|---|---|
| 输入 | (B, 2) |
每个样本两个分量 |
| 隐藏层 | (B, 16) |
学习非线性组合 |
| 输出 logits | (B, 1) |
对应正类的未归一化分数 |
| 标签 | (B, 1) |
与输出形状一致的浮点 0/1 |
Tensor 负责数值运算,Dataset 描述样本集合,DataLoader 按批提供数据。小数据可以一次放入内存,但训练过程仍应保留明确的批次与数据边界。
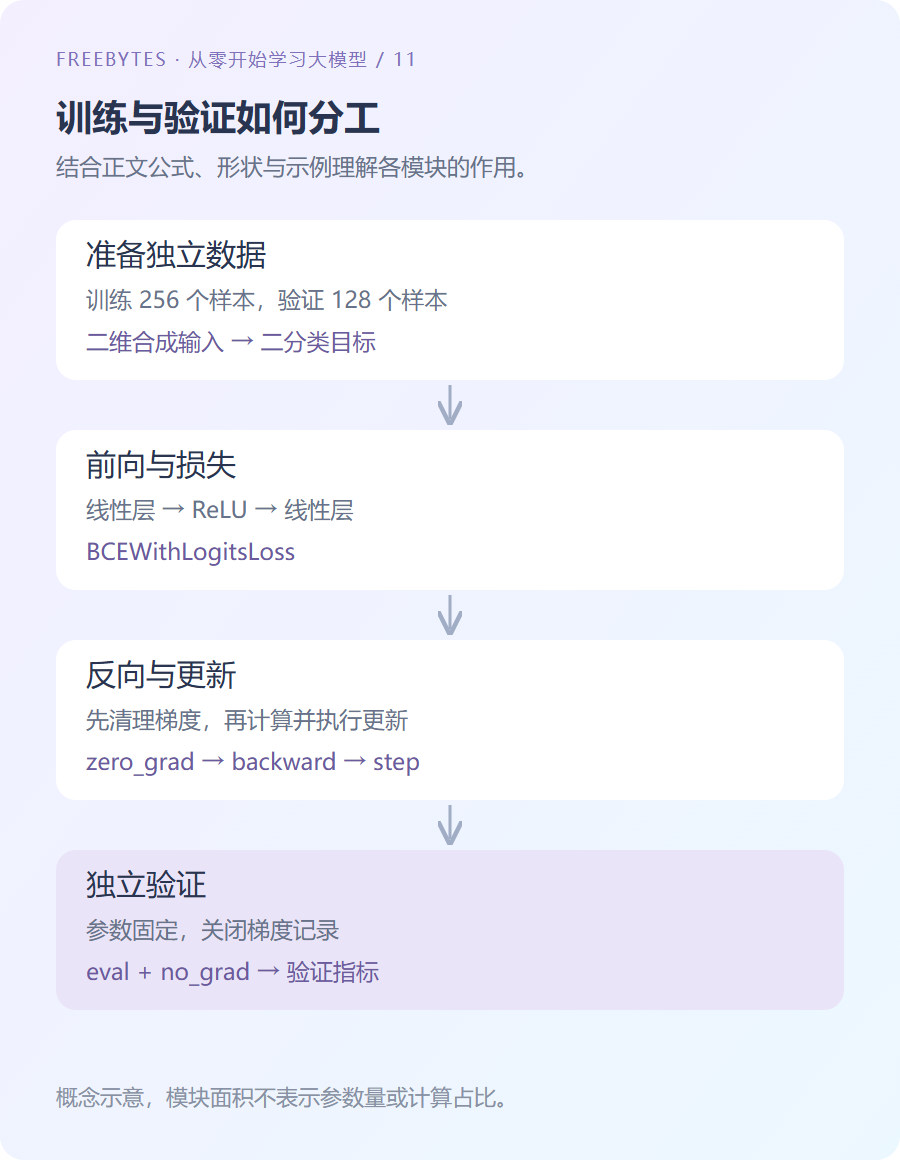
图 1:训练循环中的数据与参数流向。验证阶段不执行反向传播和更新。
2. 完整训练代码
BCEWithLogitsLoss 内部组合了适合二分类的概率变换与稳定损失计算,因此训练前不再额外应用 Sigmoid。
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader

torch.manual_seed(7)
torch.set_num_threads(1)
train_x = torch.randn(256, 2)
valid_x = torch.randn(128, 2)
train_y = (train_x[:, 0] * train_x[:, 1] > 0).float().unsqueeze(1)
valid_y = (valid_x[:, 0] * valid_x[:, 1] > 0).float().unsqueeze(1)
loader = DataLoader(TensorDataset(train_x, train_y), batch_size=32, shuffle=True)
model = nn.Sequential(nn.Linear(2, 16), nn.ReLU(), nn.Linear(16, 1))
criterion = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.03)

model.eval()
with torch.no_grad():
    initial = criterion(model(valid_x), valid_y).item()
for epoch in range(100):
    model.train()
    for inputs, targets in loader:
        optimizer.zero_grad(set_to_none=True)
        loss = criterion(model(inputs), targets)
        loss.backward()
        optimizer.step()

model.eval()
with torch.no_grad():
    logits = model(valid_x)
    final = criterion(logits, valid_y).item()
    accuracy = ((logits >= 0) == valid_y.bool()).float().mean().item()
assert final < initial
print(round(initial, 4), round(final, 4), round(accuracy, 4))
代码只要求验证损失低于初始值,不把某个固定准确率当作跨版本保证。随机种子有助于复现,但不保证不同硬件、软件版本或算法实现逐位相同。本次验收(2026-10-28,PyTorch 2.6.0 CPU)中,验证损失从约 0.7286 降至 0.0290,128 个合成验证样本的准确率为 1.0。这只反映该受控实验,不能作为真实任务效果或跨环境结果的保证;完整环境和输出保存在本地验收记录中。
3. 训练与验证需要分别设置什么
| 操作 | 训练阶段 | 验证阶段 |
|---|---|---|
| 模型模式 | model.train() |
model.eval() |
| 梯度记录 | 保留用于反向传播 | 常使用 no_grad() |
| 参数更新 | 调用优化器 | 不更新 |
| 指标用途 | 观察拟合与优化 | 观察泛化、选择方案 |
eval() 会影响 Dropout、BatchNorm 等模块的行为,但本身不关闭自动微分;no_grad() 关闭该上下文内的梯度记录,但不自动切换模型模式。本例虽未使用这些特殊模块,仍保留正确结构。
这里使用 logits 的零阈值分类,等价于 Sigmoid 概率的 0.5 阈值。是否调整阈值,应由独立的验证依据决定,不能反复用最终测试集选择。
4. 如何观察训练是否正常
应记录多个批次或整轮平均损失,而不是只报告最后一个小批次。检查标签形状、类别分布、梯度是否有限,以及验证损失是否异常,是比单看训练轮数更有效的诊断方式。
示例的 100 轮为预先指定的教学设置,没有根据验证结果反复挑选网络。真实实验可使用验证集早停,但最终还需要未参与选择的测试集。
训练完成可保存 state_dict,并记录网络结构、预处理和版本。若需要恢复训练,还应保存优化器、训练进度及必要的随机状态。加载来源不明的模型文件前应核查来源和加载方式;可优先采用适当的仅权重加载接口。
5. 小结
一次完整训练包含清理梯度、前向计算、计算损失、反向传播和参数更新;验证则使用固定参数计算独立数据的表现。这个流程会继续用于 CNN、RNN 与 Transformer。
下一篇介绍卷积如何利用图像的局部结构。接口解释可参考 PyTorch 官方训练教程。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
上一篇:手算一个神经网络的反向传播