从零开始学习大模型(十三):从经典 CNN 到 ResNet,深层网络如何训练?
卷积说明了图像特征如何计算,但增加网络层数还会带来新的优化问题。深层网络理论上可以表达更复杂的函数,并不意味着实际训练一定更容易或结果一定更好。
本篇关注经典架构解决的问题,而不是背诵每个网络的层数与排行榜数字。
1. 经典 CNN 的主要设计变化
| 架构 | 代表性设计 | 学习重点 |
|---|---|---|
| LeNet | 卷积、下采样与全连接组合 | 图像分类的基本流程 |
| AlexNet | 更大规模卷积网络、ReLU 等 | 数据、计算与训练方法共同影响效果 |
| VGG | 堆叠较小卷积核构造深网络 | 深度与规则化模块设计 |
| ResNet | 残差分支与快捷连接 | 改善深层网络优化 |
不同架构的具体变体、输入设置和训练方案不同,不能把历史结果当作在任意新数据集上的直接比较。参数量与计算量也不是同一个指标。
2. 深度增加为什么可能更难优化
在长链式计算中,梯度需要经过多次局部导数变换,可能变小或变大。初始化、激活函数和归一化都会影响传播。
此外,深网络也可能出现训练误差随深度增加而变差的退化问题。这不同于“训练误差低、验证误差高”的典型过拟合现象,应先区分优化困难与泛化问题。
3. 残差连接如何定义
残差块将输出写为 y = x + F(x)。F 是可训练分支,快捷连接直接传递 x,使模块可以学习相对输入的修正。
若对 x 求导,在可导条件下形式为 ∂y/∂x = I + ∂F/∂x。恒等路径为信息和梯度传播提供另一条路线,但不保证所有梯度问题自动消失。
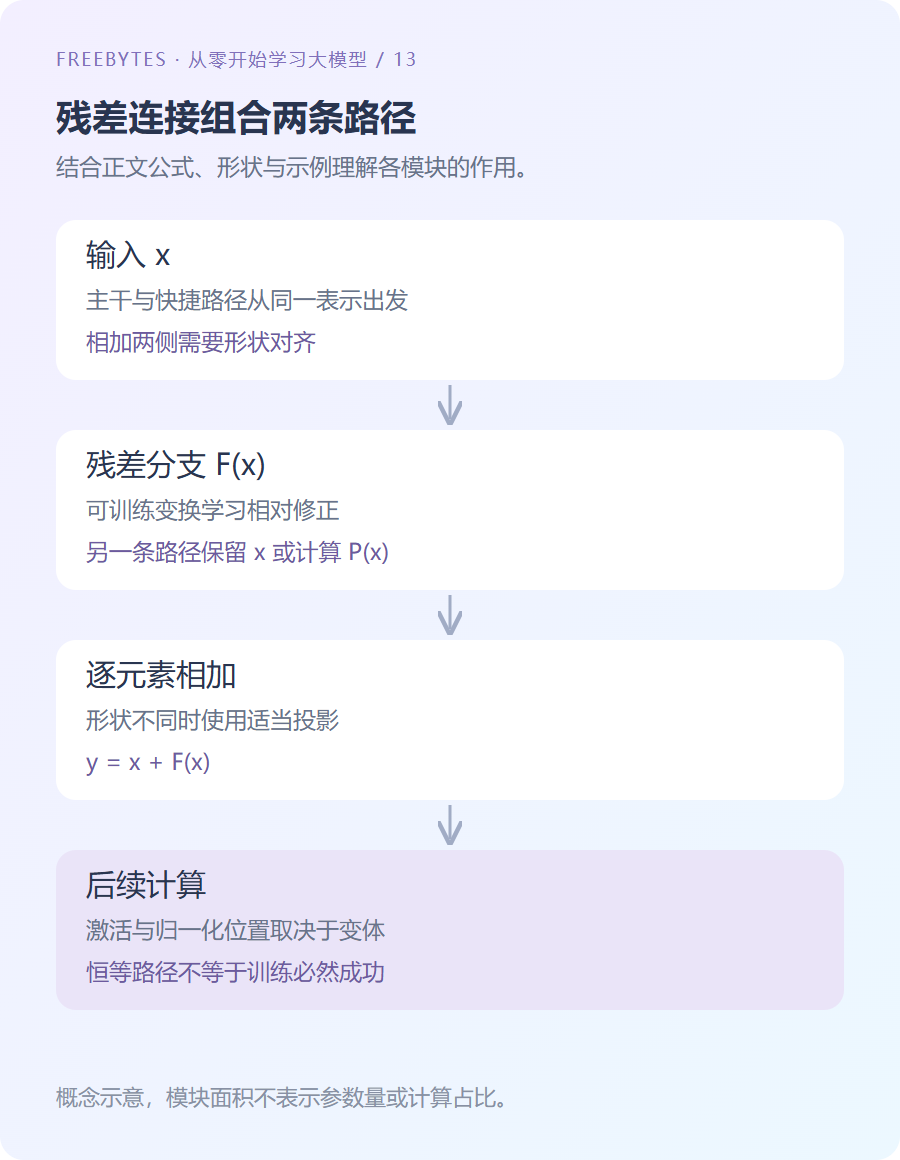
图 1:残差连接在相同形状下逐元素相加;形状不匹配时需要适当投影。
若通道数或空间大小改变,不能直接相加,常使用投影 P(x),得到 y = P(x) + F(x)。投影可能引入额外参数和计算,并非所有快捷路径都完全无参数。
| 设置 | 能否直接相加 | 处理方式 |
|---|---|---|
| 两侧形状完全相同 | 可以 | 逐元素相加 |
| 通道数量不同 | 不可以直接按残差语义相加 | 例如使用 1×1 卷积投影 |
| 空间分辨率不同 | 不可以直接相加 | 对齐下采样与投影 |
| 数组框架允许广播 | 仍需检查 | 广播成功不代表残差设计正确 |
4. 用最小例子检查残差与梯度
令 F(x)=ax,则 y=(1+a)x,导数为 1+a。这是标量形式,不是完整卷积块,但可以核对恒等路径的作用。
from math import isclose

def residual(x, a):
    return x + a * x

x, a, epsilon = 2.0, 0.25, 1e-5
numeric = (residual(x + epsilon, a) - residual(x - epsilon, a)) / (2 * epsilon)
assert isclose(residual(x, a), 2.5)
assert isclose(numeric, 1 + a, rel_tol=1e-8)
assert residual(x, 0.0) == x
print(round(numeric, 4))
当残差分支为零时,块可以保留恒等映射;它并不保证任何随机初始化的完整网络已经实现恒等函数。激活位置与归一化位置也随架构变体而改变。
5. 迁移学习如何复用已有网络
预训练模型可以提供初始化或固定的特征提取器。常见方式包括冻结主干、只训练任务头,以及逐步解冻部分或全部网络微调。
需要检查预处理与预训练要求是否一致,包括图像尺寸、通道顺序、归一化和类别输出数。输入标签和验证划分必须围绕目标任务重新设计。
冻结参数不等于切换评估模式。BatchNorm 等层的运行统计可能受训练模式影响,Dropout 的行为也由模式控制;应分别管理参数梯度和模块状态。
较少数据时,微调全部参数未必优于固定特征。数据与预训练领域差异较大时,也不能假定迁移一定带来提升。应保留从简单基线出发的独立比较。
6. 第三阶段小结
第三阶段串联了非线性网络、反向传播、框架训练、卷积与残差连接。下一阶段转向序列:RNN 如何保存状态,LSTM 如何通过门控改变信息流,以及注意力为什么有用。
残差学习的原始工作可参考 Deep Residual Learning for Image Recognition。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
下一篇:RNN 如何处理顺序与历史状态?