从零开始学习大模型(十):手算一个神经网络的反向传播
反向传播的核心是沿计算图应用链式法则。网络复杂时,框架负责记录依赖与复用中间结果;理解一个小例子,可以帮助排查损失不下降、梯度为零或参数未更新的问题。
本文选用平方损失与一个 ReLU 隐藏单元,所有输入和参数均为教学值,不使用真实业务数据。
1. 定义网络与输入
网络包含两步变换:z = w₁x₁ + w₂x₂ + b,h = ReLU(z);输出为 ŷ = vh + c,损失为 L = 0.5(ŷ − y)²。
| 量 | 取值 | 含义 |
|---|---|---|
| 输入 x₁、x₂ | 1、2 | 固定输入 |
| 权重 w₁、w₂ | 0.5、−0.5 | 输入到隐藏层 |
| 偏置 b | 1 | 隐藏层偏置 |
| 权重 v、偏置 c | 2、0 | 隐藏层到输出 |
| 目标 y | 0 | 本次训练标签 |
这里需要训练五个标量参数。输入与标签可以参与函数计算,但通常不作为待更新的模型参数。
2. 先完成前向计算
代入得到 z = 0.5×1 − 0.5×2 + 1 = 0.5,因此 h = 0.5。输出为 2×0.5 + 0 = 1,损失为 0.5。
前向阶段的中间结果会被用于求导。不能在计算完梯度之前任意覆盖这些参数或激活值,否则会破坏导数所对应的计算过程。
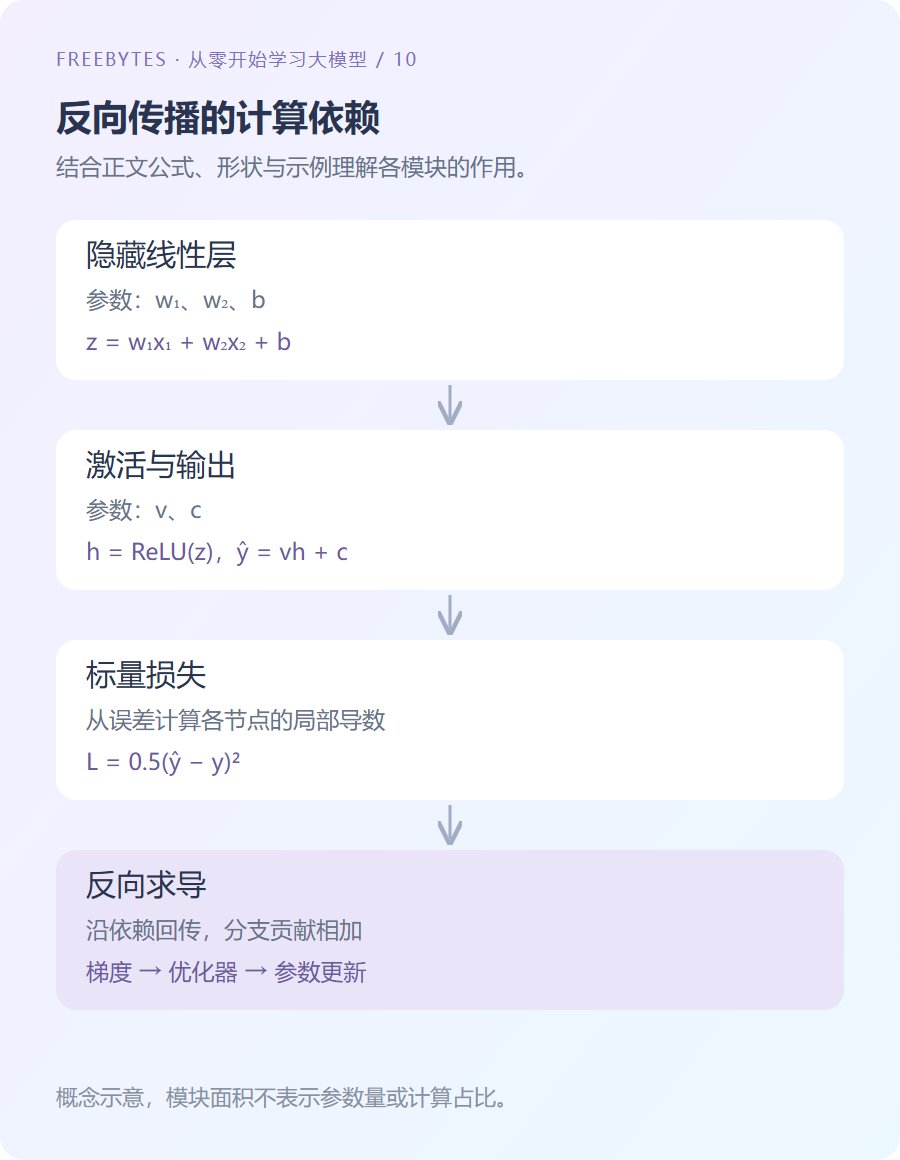
图 1:反向传播沿计算依赖求导,方向与前向生成激活的方向相反。
3. 从损失逐层求导
输出误差为 e = ŷ − y = 1,因此 ∂L/∂ŷ = 1。输出层梯度为 ∂L/∂v = eh = 0.5、∂L/∂c = e = 1,同时传给隐藏单元的梯度是 ∂L/∂h = ev = 2。
本例 z 大于零,ReLU 在该点的导数为 1,因此 ∂L/∂z = 2。继续向输入层求导:
| 参数 | 链式法则 | 梯度 |
|---|---|---|
| w₁ | (∂L/∂z) × x₁ |
2 |
| w₂ | (∂L/∂z) × x₂ |
4 |
| b | ∂L/∂z |
2 |
| v | (∂L/∂ŷ) × h |
0.5 |
| c | ∂L/∂ŷ |
1 |
如果同一个中间变量通过多条路径影响损失,需要把各路径贡献相加。反向传播不是在分叉处随意选择一条路径。
4. 用有限差分独立核对梯度
中心差分用 [L(θ+ε) − L(θ−ε)] / (2ε) 近似导数。它适合检查小型网络,但每个参数都需要额外前向计算,不能替代大型模型的高效训练。
from math import isclose

def loss(p):
    w1, w2, b, v, c = p
    h = max(0.0, w1 + 2.0 * w2 + b)
    return 0.5 * (v * h + c) ** 2

parameters = [0.5, -0.5, 1.0, 2.0, 0.0]
expected = [2.0, 4.0, 2.0, 0.5, 1.0]
epsilon = 1e-5
for i, gradient in enumerate(expected):
    plus, minus = parameters.copy(), parameters.copy()
    plus[i] += epsilon
    minus[i] -= epsilon
    numeric = (loss(plus) - loss(minus)) / (2 * epsilon)
    assert isclose(numeric, gradient, rel_tol=1e-7)

updated = [p - 0.1 * g for p, g in zip(parameters, expected)]
assert isclose(loss(parameters), 0.5)
assert isclose(loss(updated), 0.005)
print(round(loss(updated), 4))
本例使用学习率 0.1 后损失下降,但这不保证任意网络和学习率都如此。有限差分也受舍入误差与步长选择影响;在 ReLU 的零点附近,函数不可导,不能要求数值近似与框架约定始终一致。
5. 自动微分实际负责什么
常见反向模式自动微分根据实际执行的运算建立依赖,计算损失相对于叶子参数的梯度。它计算的是程序定义的函数,并不检查目标设计是否符合真实需求。
反向传播不等于更新参数。优化器读取梯度后,才按梯度下降、动量或 Adam 等规则调整权重。许多框架会累加梯度,因此新一轮训练前需要显式清理,或有意按照梯度累积策略处理。
还要注意张量形状。广播可能使程序正常运行,却计算了不符合预期的损失;梯度存在也不证明训练逻辑正确。检查预测与标签维度、损失归约方式及参数是否被优化器管理,是必要步骤。
6. 小结
先确定前向依赖,再从标量损失反向应用链式法则,可以逐项得到参数梯度。数值检查用于核对局部实现,验证集则用于检验训练结果,两者解决不同问题。
下一篇使用 PyTorch 完成可运行的训练循环。更完整的训练流程可参考 PyTorch:Optimizing Model Parameters。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
上一篇:神经网络为什么需要非线性?