从零开始学习大模型(二):向量、矩阵与张量,模型如何处理数据?
语言模型接收文本,但其内部计算主要发生在数值之间。文本需要先转换为 Token 编号,再映射成向量;多个位置上的向量组成矩阵;批量处理时,还会增加批次等维度。
因此,理解模型结构的第一步,是明确三个问题:数据如何表示、数据具有什么形状,以及运算如何改变形状。本文围绕这些问题介绍必要的线性代数,不要求读者事先掌握完整的数学课程。
1. 从标量到张量:数值的组织方式
**标量(Scalar)**是一个数,例如学习率 0.01 或某个样本的损失值。
**向量(Vector)**可以表示一组有顺序的数。例如,用三个经过适当处理的特征描述一个样本,可以写成 x = [1, 2, 3]。每个位置的含义必须保持一致,否则两个样本就无法在相同规则下比较。
**矩阵(Matrix)**将数值按行与列组织。若每行对应一个样本、每列对应一种特征,两个样本、三个特征可以组成一个 2 × 3 的矩阵。
**张量(Tensor)**在深度学习框架中通常指可包含多个轴的数值数组。标量、向量和矩阵都可以视为张量的特殊情况。
| 对象 | 示例 | 形状 | 常见用途 |
|---|---|---|---|
| 标量 | 0.01 |
() |
学习率、单个损失值 |
| 向量 | [1, 2, 3] |
(3,) |
一个样本或 Token 的表示 |
| 矩阵 | 两行、每行三个数 | (2, 3) |
一批样本或一段序列 |
| 三维张量 | 两个序列、各四个位置、每位置三个数 | (2, 4, 3) |
批量文本的向量表示 |
这里的“维度”可能指向量中分量的数量,也可能指数组的轴数。例如,一个包含 128 个分量的向量,形状为 (128,),但数组只有一个轴。阅读框架文档时,需要结合语境区分。
此外,张量的轴数有时称为阶数或 rank,不能与线性代数中“矩阵的秩”混为一谈。后者描述行或列的线性独立程度。
2. 点积:从多个输入得到一个结果
两个长度相同的向量做点积,需要将对应位置相乘,再把结果相加。
设输入与权重分别为:
x = [1, 2, 3]
w = [1, 0, 1]

x · w = 1×1 + 2×0 + 3×1 = 4
结果是一个标量。在线性模型中,点积可以将多个特征组合成一个输出;再加上偏置 b,得到 y = x · w + b。
权重并不一定由开发者手动指定。实际训练会根据数据和损失函数调整权重,使组合后的输出更符合任务要求。
点积还与向量的长度和夹角有关:x · w = ||x|| × ||w|| × cos(θ)。这里 ||x|| 表示向量的欧几里得长度,θ 是两个非零向量之间的夹角。
因此,点积较大可能来自方向更接近,也可能仅仅来自向量更长。不能把原始点积直接解释为不受尺度影响的语义相似度。
3. 矩阵乘法:同时进行多个点积
如果需要将每个样本转换成多个输出,可以把多组权重组织成矩阵。本文采用“样本按行排列”的约定,计算写作 Y = XW。
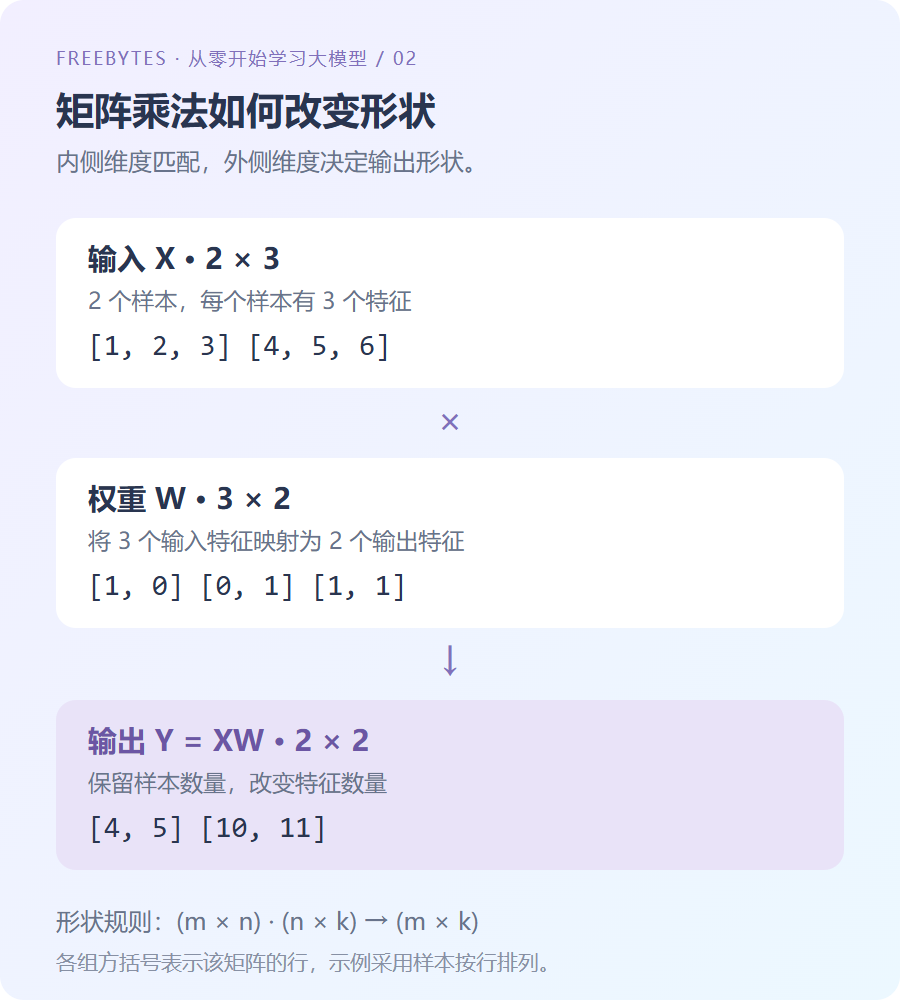
图 1:矩阵乘法的形状关系。示例采用行向量约定;其他资料也可能使用列向量约定。
设矩阵如下:
X = [[1, 2, 3],       W = [[1, 0],
     [4, 5, 6]]           [0, 1],
                          [1, 1]]
X 的形状为 2 × 3,W 的形状为 3 × 2。前者的列数与后者的行数相同,允许相乘,结果形状为 2 × 2。
输出第一行的两个元素分别为:
Y[0, 0] = 1×1 + 2×0 + 3×1 = 4
Y[0, 1] = 1×0 + 2×1 + 3×1 = 5

Y = [[ 4,  5],
     [10, 11]]
矩阵乘法不是对应位置相乘。 对应位置相乘称为逐元素乘法;它与矩阵乘法有不同的形状规则和数学含义。矩阵乘法通常也不满足交换律,即 AB 与 BA 可能结果不同,甚至只有一个方向能够计算。
加入偏置后,线性层可以写成 Y = XW + b。在常见数组框架中,形状为 (2,) 的偏置可以通过广播加到每一行。广播依据轴长度规则进行,并不代表任意不同形状都能相加。
4. 为什么阅读模型时应先检查形状
对每一步标注形状,可以在代入具体数字之前发现许多错误。
| 运算 | 输入形状示例 | 输出形状 | 注意事项 |
|---|---|---|---|
| 点积 | (3,) 与 (3,) |
标量 | 分量数量必须相同 |
| 矩阵乘法 | (2, 3) 与 (3, 2) |
(2, 2) |
内侧维度匹配 |
| 矩阵转置 | (2, 3) |
(3, 2) |
交换行轴与列轴 |
| 逐元素相加 | (2, 3) 与 (2, 3) |
(2, 3) |
对应位置相加 |
| 加入偏置 | (2, 2) 与 (2,) |
(2, 2) |
依照广播规则作用于各行 |
需要特别区分转置和 reshape。转置交换轴,例如将矩阵的行列对调;reshape 改变数组的组织形状,元素总数必须一致。两者一般不会得到相同结果,不能仅因为目标形状一致就相互替代。
5. 文字如何变成向量:Embedding
分词器先将文本转换为 Token 编号。编号只是离散索引,其数值大小并不代表词义大小或语义距离。
假设一个教学用词表包含 1000 个 Token,每个 Token 用 64 个数表示,可以使用一个形状为 (1000, 64) 的 Embedding 表。输入某个编号时,查出对应行,就获得长度为 64 的向量。
Embedding 向量通常在训练中学习得到。它们不要求每一个分量都对应某个可命名的属性,也不能预先认定某一维表示“语法”、另一维表示“情感”。有用的信息往往分布在多个分量与其组合中。
还需要区分两类表示:
- 输入 Embedding:同一 Token 编号查询相同的向量表时,得到相同的初始向量。
- 上下文表示:向量经过后续模型层后,会受到其他位置、位置编码及模型结构影响;同一 Token 在不同上下文中,最终表示可能不同。
用 B 表示批次中的序列数量、T 表示序列长度、D 表示表示维度,则一批文本常以 (B, T, D) 组织。例如 (2, 4, 64) 表示两条序列,每条四个位置,每个位置对应 64 个数。这是布局约定之一,其他实现可能交换轴顺序。
6. 长度、相似度与数值尺度
对于 x = [3, 4],欧几里得长度为 sqrt(3² + 4²) = 5。将向量除以自身长度可以得到单位向量,但零向量无法直接进行这种归一化。
两个非零向量的余弦相似度为:
cosine(x, y) = (x · y) / (||x|| × ||y||)
例如 [1, 2] 与 [2, 4] 方向相同,余弦相似度为 1,但二者的长度并不相同。
余弦相似度是否适合比较语义,取决于表示模型、训练目标与任务,不能只因为输入是向量就默认其具备语义意义。
在人工构造的特征中,还要关注单位和尺度。例如年龄、收入和距离的数量级可能不同。标准化、归一化有不同定义,需要使用训练数据确定处理规则,再一致地应用于验证和测试数据,避免数据泄漏。特征缩放也不同于对每个 Embedding 向量做长度归一化。
7. 一个可运行的计算示例
下面仅使用 Python 标准库,验证本文的点积与矩阵乘法。代码限定为非空、形状规则的二维列表,目的是展示计算过程,不替代数值计算库。
def dot(a, b):
    if len(a) != len(b):
        raise ValueError("向量长度不一致")
    return sum(x * y for x, y in zip(a, b))


x = [[1, 2, 3], [4, 5, 6]]
w = [[1, 0], [0, 1], [1, 1]]
columns = list(zip(*w))
y = [[dot(row, column) for column in columns] for row in x]

assert y == [[4, 5], [10, 11]]
print(y)
8. 小结与自测
本篇需要掌握的重点是:向量组织一组分量,矩阵组织行列数据,张量扩展到更多轴;点积产生标量,矩阵乘法批量组合特征;Embedding 则把离散 Token 映射为可训练的向量表示。
可以用三个问题检查理解:
(8, 16)与(16, 32)相乘,结果是什么形状?答案是(8, 32)。(8, 16)与(8, 32)能按普通二维矩阵乘法直接相乘吗?不能,内侧维度不匹配。- 两个向量余弦相似度为 1,是否意味着元素完全相同?不一定,它们可以具有不同长度。
关于线性代数定义与更多练习,可进一步阅读 Dive into Deep Learning:Linear Algebra。下一篇将解释参数如何通过梯度下降更新。