从零开始学习大模型(十八):Q、K、V 到底是什么?手算自注意力
自注意力将同一序列的表示分别投影为 Query、Key 和 Value,再通过匹配与聚合产生新的表示。Q/K/V 是计算角色,不是三份天然不同的原始文本。
本文固定一个单头、无掩码的最小例子,重点验证每一步,而不把示例权重描述为真实模型学到的语言规律。
1. 从投影开始核对形状
若输入 X 形状为 (T,D),可写 Q=XW_Q、K=XW_K、V=XW_V。Q 和 K 的最后维度需要一致,Value 的宽度则可以单独设定。
| 对象 | 形状 | 作用 |
|---|---|---|
| Q | (T,d_k) |
每个位置的查询 |
| K | (T,d_k) |
每个位置的键 |
| V | (T,d_v) |
待聚合的内容 |
| QKᵀ | (T,T) |
查询位置与键位置的匹配 |
投影矩阵是可训练参数,Q/K/V 是输入相关的中间结果。批次与多头会增加额外轴,但不会改变这几个核心形状关系。
2. 给定两个位置的数值
设 Q=K=[[1,0],[0,1]],V=[[2,0],[0,4]]。则 QKᵀ 是单位矩阵,除以 sqrt(d_k)=sqrt(2) 后得到对角元素约为 0.7071 的分数矩阵。
缩放有助于控制较大键维度下点积分数的尺度,这是基于相应数值条件的设计,并不是对所有数据分布都精确成立的方差保证。
对第一行 [0.7071,0] 做 Softmax,得到约 [0.6698,0.3302]。第二行的权重则对调。
| 步骤 | 第一行结果(约) | 说明 |
|---|---|---|
| 点积 | [1,0] |
计算与两个键的匹配 |
| 缩放 | [0.7071,0] |
除以 sqrt(2) |
| Softmax | [0.6698,0.3302] |
沿候选键位置归一化 |
| 聚合 Value | [1.3395,1.3210] |
两个值向量的加权和 |
Softmax 按每个查询对应的候选键分别计算。对整个矩阵一次归一化,或沿错误轴计算,会改变算法意义。
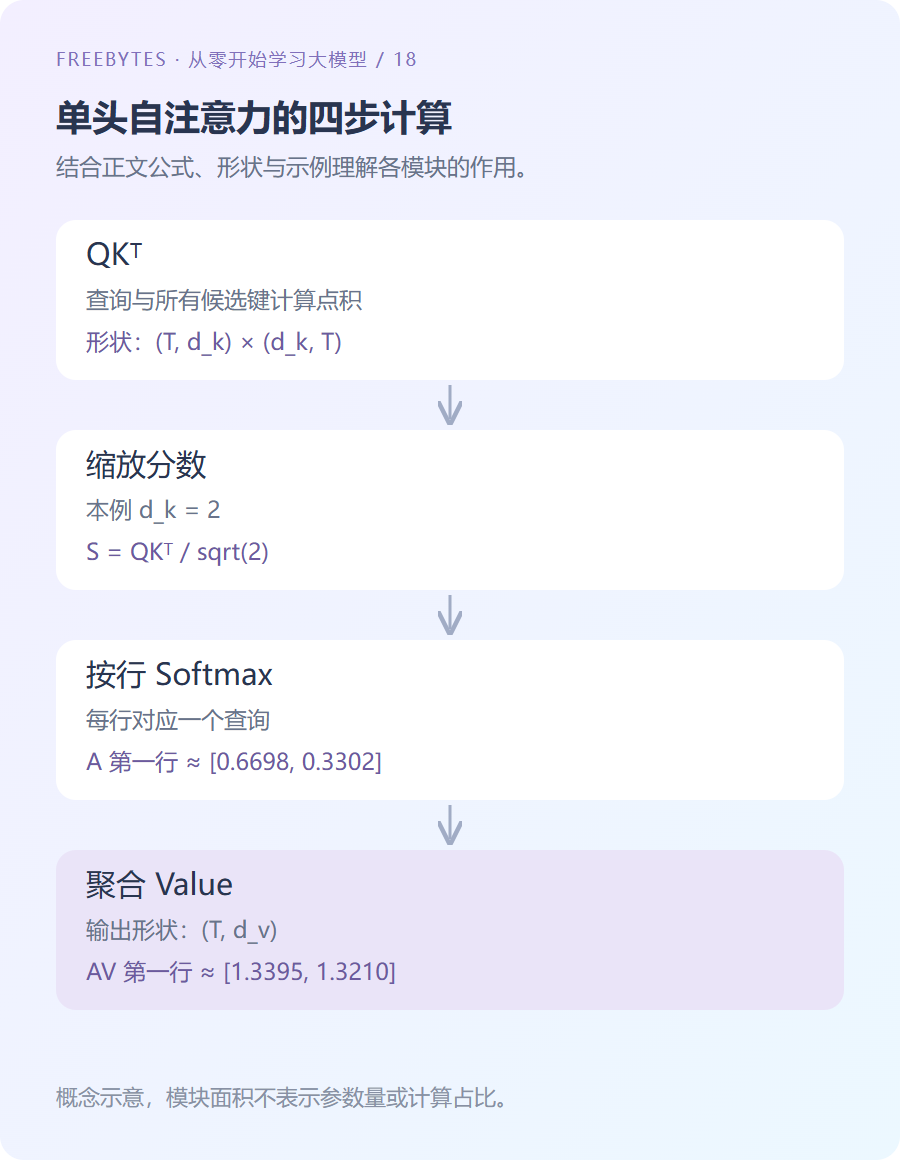
图 1:完整公式为 Attention(Q,K,V)=softmax(QKᵀ/sqrt(d_k))V,本例不含掩码或 Dropout。
3. 用 Python 复算整个输出
from math import exp, sqrt, isclose

q = [[1.0, 0.0], [0.0, 1.0]]
k = [[1.0, 0.0], [0.0, 1.0]]
v = [[2.0, 0.0], [0.0, 4.0]]
scores = [[sum(a*b for a, b in zip(query, key)) / sqrt(2)
           for key in k] for query in q]
weights = []
for row in scores:
    terms = [exp(x - max(row)) for x in row]
    weights.append([x / sum(terms) for x in terms])
output = [[sum(weights[i][j] * v[j][d] for j in range(2))
           for d in range(2)] for i in range(2)]
assert all(isclose(sum(row), 1.0) for row in weights)
assert isclose(output[0][0], 2 * weights[0][0])
assert isclose(output[0][1], 4 * weights[0][1])
print([[round(x, 4) for x in row] for row in output])
输出形状为 (T,d_v),每一行是对应查询聚合后的向量,不是一个单独的“匹配对象编号”。最高权重并不会令其余位置必然消失。
4. 自注意力是否保留原始信息
聚合结果还会经过输出投影,并常与原输入走残差连接。最终表示包含多条路径的贡献,不能只通过注意力矩阵解释完整模型。
在没有额外位置机制、掩码或其他顺序信息时,普通自注意力对输入排列具有相应的置换等变关系。这说明它能够比较内容,但不天然知道每个内容在序列中的先后位置。
本例同时包含自身位置。某些任务会施加不同访问约束,因果语言模型通常允许看到当前位置及以前位置,再在输出端预测下一个 Token。标签偏移与掩码必须配合正确。
5. 小结
核对自注意力可以遵循四步:检查 Q/K/V 来源与形状,计算缩放分数,沿正确轴应用掩码和 Softmax,最后聚合 V。多头与位置机制将在下一篇展开。
公式来源与整体设计见 Attention Is All You Need。
本阶段目录
系列学习路线
- 数学与基本概念(第 1—4 篇)
- 传统机器学习(第 5—8 篇)
- 神经网络与 CNN(第 9—13 篇)
- RNN、LSTM 与注意力(第 14—16 篇)
- Transformer(第 17—20 篇)
- 大模型训练与应用(第 21—24 篇)
下一篇:多头注意力、位置编码与因果掩码