从零开始学习大模型(十九):多头注意力、位置编码与因果掩码
单头注意力说明了内容如何匹配。完整模型还需要决定以多少组投影进行计算、如何表示顺序,以及哪些位置可以互相访问。多头、位置机制和掩码分别解决不同问题,不能互相替代。
1. 多头注意力增加了什么
每个头使用自己的投影,在较低维的子空间计算注意力,随后把各头结果拼接并通过输出投影组合。常见设置满足 D = H × d_head。
| 概念 | 作用 | 不应直接推断 |
|---|---|---|
| 头数 H | 多组投影与聚合 | 更多头必然更好 |
| 头宽 d_head | 每个头的表示宽度 | 每个头都有固定语义标签 |
| 输出投影 | 重新组合各头结果 | 只是简单求平均 |
| 主干宽度 D | 层间传递的特征宽度 | 与词表大小相同 |
固定 D 时增加头数通常会降低单头宽度;也会影响内核效率、缓存布局与表达方式。实际实现可能采用共享键值的 MQA/GQA,不能默认 Q、K、V 的头数永远相同。
2. 位置机制如何加入顺序信息
绝对位置向量可以与输入相加,位置向量可学习或按函数构造。相对位置方法可以修改注意力分数或表示变换,使位置差参与计算。
RoPE 常对 Q 和 K 的成对分量施加随位置变化的旋转。在适当配对与频率设置下,旋转后点积可以用相对位置差表达。它不是给 Token 编号简单加上一个位置数字,也不要求对 Value 采取同样变换。
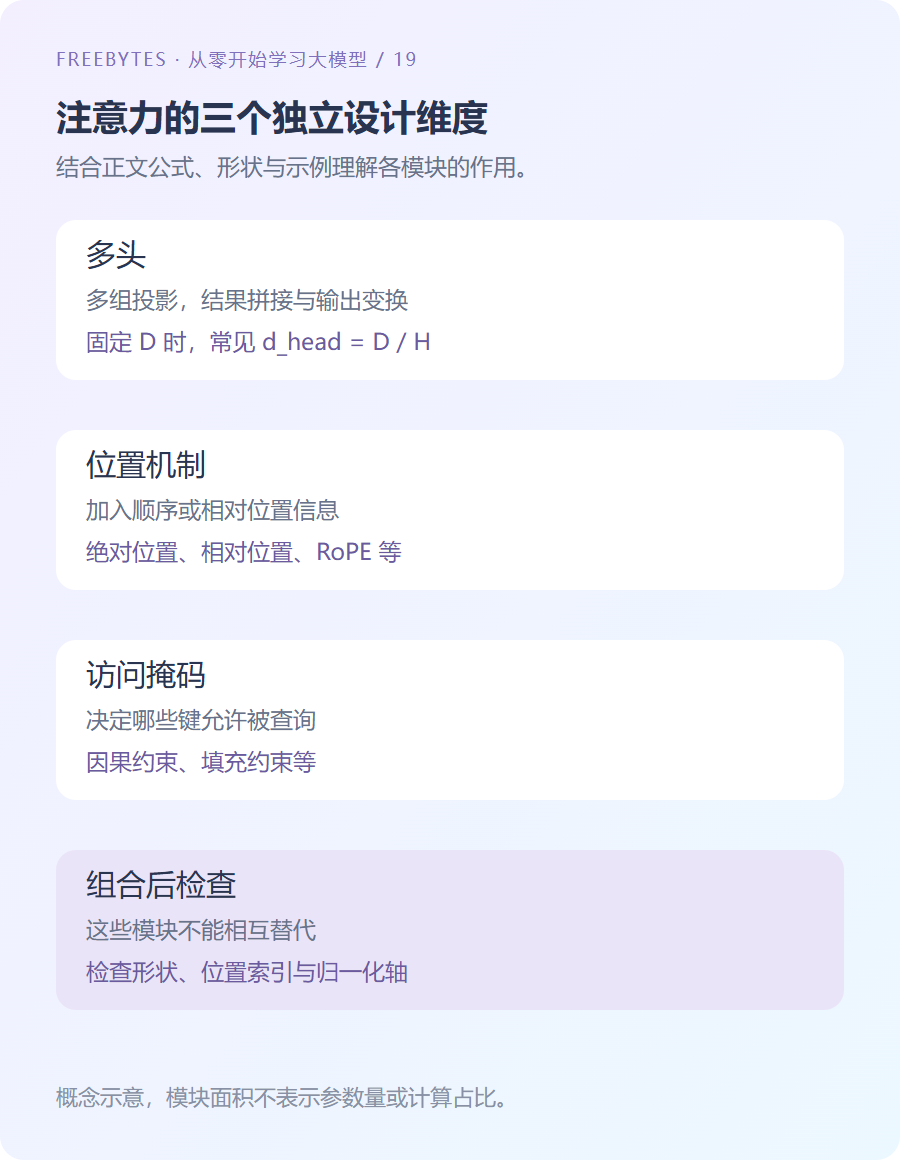
图 1:多头决定计算分组,位置机制提供顺序信息,掩码限定访问关系。
3. 因果掩码如何避免读取未来
对按从左到右生成的序列,位置 t 通常只允许访问索引不大于 t 的键。可在不允许的位置给分数加上负无穷,使 Softmax 后相应权重为零。
| 掩码类型 | 排除对象 | 检查要点 |
|---|---|---|
| 因果掩码 | 未来位置 | 注意当前输入与目标的偏移 |
| 填充掩码 | 无效填充位置 | 变长样本不能混入填充统计 |
| 组合掩码 | 多种限制 | 避免整行没有合法键 |
| 缓存场景掩码 | 结合过去与当前的位置关系 | 不只看局部矩阵索引 |
框架对布尔掩码中 True 的含义可能不同,必须查看具体接口。整行全部被屏蔽后,直接 Softmax 可能产生未定义值,不能忽略。
4. 验证旋转与屏蔽
下面只演示一个二维旋转对,不实现完整多频率 RoPE。随后对两个合法候选分数归一化,将第三个未来位置明确设为零。
from math import cos, sin, exp, isclose

def rotate(v, angle):
    return [v[0]*cos(angle) - v[1]*sin(angle),
            v[0]*sin(angle) + v[1]*cos(angle)]

def dot(a, b):
    return sum(x*y for x, y in zip(a, b))

q, k, frequency = [1.0, 2.0], [3.0, 4.0], 0.3
left = dot(rotate(q, 2*frequency), rotate(k, 5*frequency))
right = dot(q, rotate(k, (5-2)*frequency))
assert isclose(left, right)
allowed = [0.0, 1.0]
terms = [exp(x - max(allowed)) for x in allowed]
weights = [x / sum(terms) for x in terms] + [0.0]
assert isclose(sum(weights), 1.0) and weights[2] == 0.0
print([round(x, 4) for x in weights])
实际程序通常通过矩阵掩码完成屏蔽,不应在不了解广播规则时直接套用这段单行示例。
5. 上下文变长并不自动保证效果
位置机制能够计算某个更大的位置,不表示模型已在对应长度上可靠工作。训练长度、位置缩放、注意力模式和数据分布都会影响外推。
此外,长序列增加注意力计算和 KV Cache 开销。不能只修改一个最大长度配置就承诺长文本质量与吞吐保持不变,应专门评估长距离检索、位置偏差和延迟。
下一篇比较 BERT、GPT 与 T5 的结构与训练目标。RoPE 的推导见 RoFormer。